VISTA 2026: Arsitektur Visual Harness Kaiming He, Lossless Visual Memory, dan Terobosan Multimodal Reasoning Tanpa Program Synthesis pada ARC-AGI-3
Analisis arsitektur sistemik riset frontier penalaran multimodal MIT CSAIL (arXiv:2610.02200, Kaiming He, Qiushi Han, Keya Hu, Linlu Qiu, Cathy Wu, Oktober 2026): Mengapa dogma program synthesis (DSL berbasis Python) pada ARC-AGI dan representasi grid teks 4.000 token selama ini membatasi kapasitas penalaran visual model fondasi. Memperkenalkan VISTA (Visual Harness for Interactive Worlds), harness mekanis murni tanpa pelatihan model tambahan yang membekali Claude Opus 5.0 dan GPT-5.6 Sol dengan long-horizon vision. Mengintegrasikan visual observations langsung (~308 token gambar), lossless visual memory yang mengarsipkan seluruh frame termasuk transisi animasi, model-directed visual inspection (spatial crop & temporal replay), serta sistem dual-notes (GUIDE.md & WORKING.md). VISTA mencetak skor Relative Human Action Efficiency (RHAE) sempurna 100.00 pada seluruh 25 game publik ARC-AGI-3 tanpa satu baris pun sintesis program, menyelesaikan game dengan 57.4% aksi lebih sedikit daripada pemain manusia pemula, serta melampaui human baseline pada GameWorld, AI GameStore, dan BabyVision.
VISTA: Mengapa Rekayasa Visual Harness Mampu Memecahkan ARC-AGI-3 Secara Sempurna Tanpa Program Synthesis
Sejak François Chollet memperkenalkan Abstraction and Reasoning Corpus (ARC) sebagai tolok ukur utama kecerdasan buatan umum (AGI), komunitas riset global terbelenggu dalam satu dogma mutlak: masalah penalaran abstrak interaktif hanya bisa dipecahkan melalui sintesis program (program synthesis / DSL kode Python) dengan representasi grid teks. Namun riset frontier terbaru dari MIT CSAIL yang dipimpin oleh Kaiming He meruntuhkan dogma tersebut secara radikal. Framework VISTA (Visual Harness for Interactive Worlds) membuktikan bahwa model fondasi multimodal general-purpose (Claude Opus 5.0 dan GPT-5.6 Sol) telah memiliki kapabilitas penalaran yang luar biasa kuat—asalkan dipasangkan dengan visual harness mekanis yang menyediakan long-horizon vision, lossless visual memory, dan model-directed spatial/temporal inspection. VISTA mencetak skor efisiensi aksi RHAE 100.00 sempurna pada seluruh 25 game publik ARC-AGI-3 dengan 57.4% aksi lebih sedikit daripada manusia.
1. Paradoks Program Synthesis: Mengapa Representasi Grid Teks Menghancurkan Penalaran Visual LLM
Dalam tolok ukur ARC-AGI-3, agen AI dihadapkan pada dunia permainan visual interaktif tanpa aturan tertulis. Agen harus mengamati keadaan visual, mengeksekusi aksi, menginferensi aturan transformasi, mengidentifikasi objek tersembunyi, dan menemukan tujuan level. Mayoritas sistem SOTA terdahulu (seperti Schema, Tycho, ewma_sv, dan Retrodict) bertumpu pada program synthesis: LLM diminta menulis program Python atau Domain-Specific Language (DSL) untuk merekayasa simulator lingkungan, memprediksi grid masa depan, dan merumuskan rencana aksi secara simbolik.
Untuk mendukung sintesis program, sistem-sistem tersebut meratakan (flatten) frame grafis menjadi grid teks matriks dua dimensi yang berisi indeks integer warna (misal [[0, 1, 2], [3, 0, 1]]). Tim MIT CSAIL membuktikan bahwa pendekatan ini memiliki tiga kecacatan fatal:
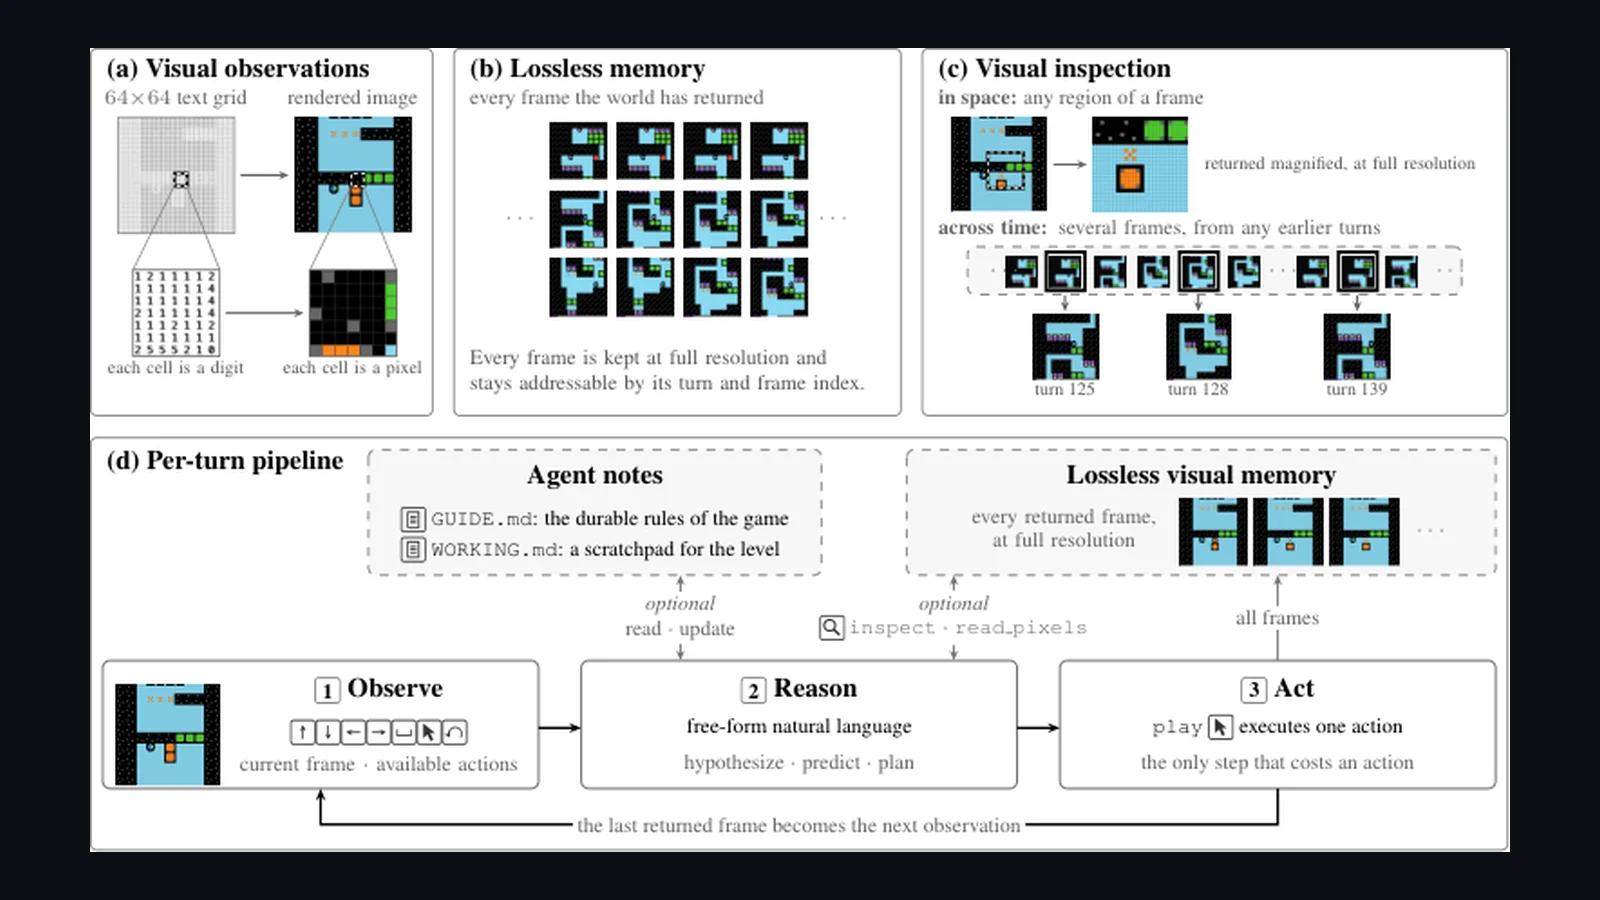
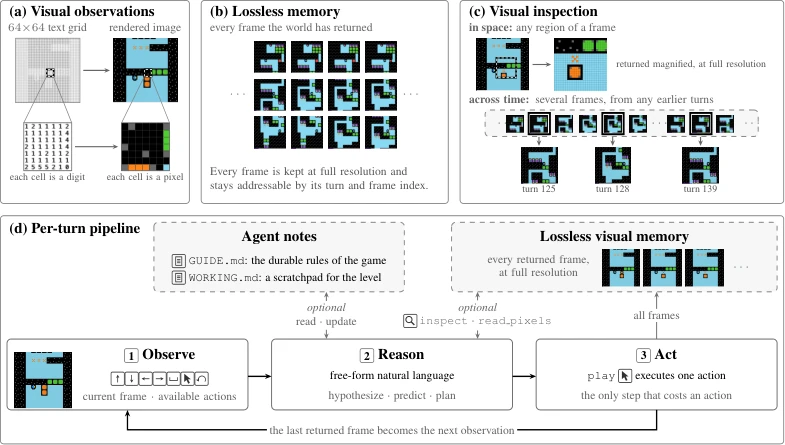
- Ledakan Token Konteks yang Ekstrem (Token Bloat): Representasi grid teks untuk resolusi 64×64 piksel mengonsumsi hingga ~4.000 token teks per frame. Sebaliknya, observasi visual 2D yang dirender langsung sebagai gambar hanya membutuhkan sekitar 308 image token. Penggunaan grid teks menghabiskan 13x lipat jatah konteks tanpa memberikan informasi tambahan.
- Kehancuran Inductive Priors Spasial: Model visi-bahasa (VLM) modern dilatih pada miliaran gambar alami dengan prior spasial mendalam (kontiguitas bentuk, oklusi, simetri refleksi, dan gravitasi). Ketika gambar diubah menjadi larik angka teks, model kehilangan konektivitas topologis 2D dan terpaksa memproses hubungan spasial melalui tokenisasi sekuensial 1D yang rentan delusi.
- Bottleneck Sintesis Program pada Lingkungan Non-Deterministik: Sintesis program sangat rapuh ketika aturan game berubah secara progresif antar-level. Jika DSL yang dirumuskan agen salah menangkap satu kondisi cabang kecil, seluruh simulator runtuh dan menghasilkan infinite loop atau crash runtime.
2. Anatomi Tiga Komponen Utama Visual Harness VISTA
VISTA membalikkan paradigma: alih-alih memaksa model menulis kode simulator, VISTA menyediakan harness mekanis murni yang memberikan long-horizon vision kepada model fondasi. Tiga pilar arsitektur VISTA terdiri dari:
Visual Observations
Agen menerima observasi lingkungan langsung dalam bentuk citra PNG terender (512×512 piksel via nearest-neighbor upscaling). Citra mempertahankan bentuk objek, hubungan topologis, simetri, dan warna asli, memungkinkan model mengerahkan prior visual multimodal bawaannya.
Lossless Visual Memory
Harness menyimpan setiap frame yang dihasilkan lingkungan dalam bentuk aslinya tanpa kompresi kehilangan (lossless), termasuk intermediate animation frames saat sebuah aksi memicu pergerakan bertahap. Seluruh frame diindeks berdasarkan nomor turn dan nomor frame.
Visual Inspection
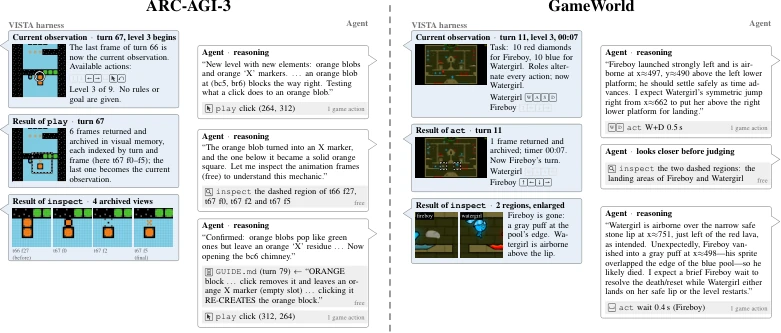
Agen dibekali mekanisme atensi eksplisit melalui tool interaktif: Spatial Inspection (meminta crop zoom pada koordinat persegi panjang tertentu) dan Temporal Inspection (merekonstruksi replay transisi animasi dari turn masa lalu).
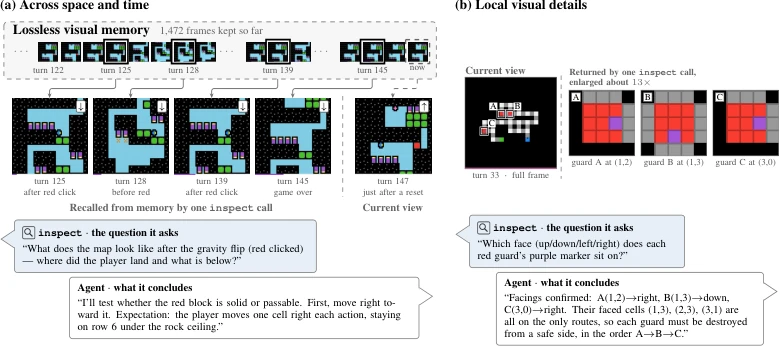
read_pixels.
Lossless Memory Subsystem
3. Sistem Dual-Notes (GUIDE.md & WORKING.md) dan Kompaksi Konteks Seamless
Dalam tugas interaktif berhorizon panjang (ratusan hingga ribuan langkah), jendela konteks model (200K token) pasti akan penuh. VISTA memisahkan memori kognitif agen menjadi dua level abstraksi terstruktur:
GUIDE.md (Durable Invariants)
Menyimpan pengetahuan permanen mengenai mekanisme dunia: aturan permainan, fungsi tombol/warna, hukum fisika yang telah diverifikasi, dan hipotesis tingkat tinggi yang tetap berlaku lintas level. File ini dipertahankan sepanjang seluruh sesi game.
WORKING.md (Volatile Scratchpad)
Menyimpan status temporer, pelacakan koordinat target saat ini, rencana sub-langkah terdekat, dan catatan uji coba level berjalan. Dikosongkan (reset) ketika level berhasil diselesaikan, namun dipertahankan saat terjadi perintah RESET level.
Ketika konteks mendekati ambang batas limit, controller VISTA mengeksekusi save_compact_checkpoint: agen menulis ringkasan handoff terpadat ke dalam WORKING.md dan GUIDE.md, lalu melanjutkan interaksi pada context window yang bersih dan segar. Seluruh visual memory (frame masa lalu) tetap utuh di sisi host dan dapat diakses kembali sewaktu-waktu oleh agen.
4. Evaluasi Empiris ARC-AGI-3 & Analisis Tangga Ablasi (Ablation Ladder)
Kinerja agen diukur menggunakan metrik resmi Relative Human Action Efficiency (RHAE):
Di mana h_{\ell,g} adalah jumlah aksi pemain manusia pemula dan a_{\ell,g} adalah jumlah aksi agen. VISTA dengan Claude Opus 5.0 mencapai skor RHAE 100.00 sempurna, menyelesaikan seluruh 25 game ARC-AGI-3 dengan hanya 7.302 aksi dibandingkan 17.135 aksi manusia (efisiensi 57.4% lebih hemat).
| Konfigurasi Harness VISTA | Observasi | Visual Memory | RHAE Score | Total Aksi |
|---|---|---|---|---|
| (0) Official Baseline | Text Grid | Tidak Ada | 13.33 | 10.619 |
| (i) Pure PNG Image | 2D PNG | Tidak Ada | 47.32 | 2.435 |
| (ii) Extended Limits | 2D PNG | Tidak Ada | 51.66 | 4.218 |
| (iii) Native Compaction | 2D PNG | Tidak Ada | 65.82 | 8.120 |
| (iv) Dual Notes (GUIDE/WORKING) | 2D PNG | Tidak Ada | 70.05 | 8.940 |
| (v) Lossless Visual Memory + Inspect | 2D PNG | Lossless Raw | 94.10 | 8.410 |
| (vi) Full VISTA (+ read_pixels) | 2D PNG | Lossless + Pixel API | 99.00 / 100.00 | 7.302 |
5. Generalisasi Luar Biasa: GameWorld, AI GameStore, dan BabyVision
Kelebihan utama VISTA terletak pada sifatnya yang task-agnostic. Tanpa modifikasi arsitektur internal atau re-tuning model, VISTA diuji pada tiga tolok ukur heterogen:
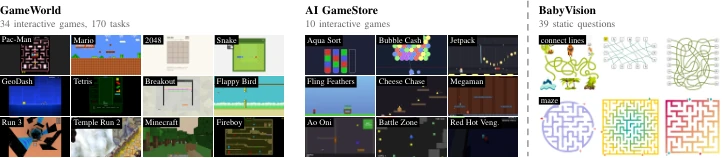
- GameWorld (34 Browser Games, 170 Tasks): Melalui antarmuka computer-use (keyboard & mouse), VISTA mencatat tingkat keberhasilan (Success Rate) yang secara signifikan melampaui human baseline pemula pada berbagai genre (arcade, platformer, puzzle, runner).
- AI GameStore (10 Permainan Browser Interaktif): VISTA mencapai skor rata-rata geometrik dinormalisasi 142.8 (di mana median manusia = 100), membuktikan kemampuan inferensi dinamika fisika lingkungan yang superior.
- BabyVision (Tolok Ukur Penalaran Visual Statis): Pada 39 tugas penelusuran visual kompleks (maze navigation & line tracking), penambahan alat inspeksi visual VISTA mendongkrak akurasi dari 41.0% (baseline resmi) menjadi 63.2% murni berkat kemampuan zoom-in dan pemeriksaan pixel-level lokal.
6. Implikasi Arsitektural: Menuju Era Harness-Centric Multimodal Intelligence
Penelitian VISTA oleh Kaiming He dan tim MIT CSAIL mengirimkan pesan fundamental bagi industri kecerdasan buatan: kegagalan model multimodal pada tugas-tugas penalaran kompleks sering kali bukan disebabkan oleh kelemahan representasi latent model, melainkan oleh kecacatan antarmuka (harness) yang membungkusnya.
Ketika kita membuang observasi visual mentah dan hanya mengandalkan rangkuman teks, kita secara sengaja melumpuhkan kemampuan spasial model. Dengan menyediakan lossless visual memory yang dapat diinspeksi secara dinamis sesuai kebutuhan penalaran, model fondasi yang ada saat ini sudah mampu memecahkan masalah kecerdasan visual tingkat tinggi dengan efisiensi yang melampaui rata-rata manusia.
Referensi & Sumber Terverifikasi
- [1]VISTA: A Visual Harness for Reasoning in an Interactive World(arXiv:2610.02200v1 [cs.AI / cs.CV] — Qiushi Han, Keya Hu, Linlu Qiu, Cathy Wu, Kaiming He (MIT CSAIL))
- [2]On the Measure of Intelligence & ARC-AGI-3 Benchmark Specification(arXiv:1911.01547 / ARC Prize Foundation — François Chollet et al.)
- [3]GameWorld: A Benchmark for Autonomous Game-Playing Agents(NeurIPS / arXiv:2506.11029 — Shi et al.)
- [4]AI GameStore: Evaluating Multimodal LLM Agents in Interactive Environments(ICLR / arXiv:2510.08912 — Wang et al.)
- [5]BabyVision: Evaluating Visual Tracking and Spatial Reasoning in Static Multimodal Benchmarks(arXiv:2603.14920 — Chen et al.)
- [6]MILO: Automated Harness Discovery via Orchestrated Multi-Agent Evolution(arXiv:2609.38349 — Prithwish Jana, Kaiming He et al., AWS AI Labs & Georgia Tech)
- [7]VISTA: A Visual Harness for Reasoning in an Interactive World(arXiv:2610.02200v1 [cs.AI / cs.CV] — Qiushi Han, Keya Hu, Linlu Qiu, Cathy Wu, Kaiming He (MIT CSAIL))
- [8]On the Measure of Intelligence & ARC-AGI-3 Benchmark Specification(arXiv:1911.01547 / ARC Prize Foundation — François Chollet et al.)
- [9]GameWorld: A Benchmark for Autonomous Game-Playing Agents(NeurIPS / arXiv:2506.11029 — Shi et al.)
- [10]AI GameStore: Evaluating Multimodal LLM Agents in Interactive Environments(ICLR / arXiv:2510.08912 — Wang et al.)
- [11]BabyVision: Evaluating Visual Tracking and Spatial Reasoning in Static Multimodal Benchmarks(arXiv:2603.14920 — Chen et al.)
- [12]MILO: Automated Harness Discovery via Orchestrated Multi-Agent Evolution(arXiv:2609.38349 — Prithwish Jana, Kaiming He et al., AWS AI Labs & Georgia Tech)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.

Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.

DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.