SwarmRSI (arXiv:2610.20431): Recursive Self-Improvement through Evolving Scientific Agent Swarm, Feedback-Guided Mutation, dan Eliminasi Dead-End Research pada Algoritma AI Ilmiah
Analisis mendalam riset frontier arXiv:2610.20431 (Qianru Meng, Xi Zhang, Konstantinos Papakostas, Congfeng Cao, Wenxiang Hu, Tianyi Lu, Xiao Zhang, Lun Zhou, Zaiqiao Meng, Zhaochun Ren, Xiaohui Yan, Yougang Lyu — Huawei Technologies, Leiden University, University of Groningen): Mengatasi dilema fundamental Recursive Self-Improvement (RSI) pada agen AI riset ilmiah. Kegagalan eksperimen sering kali mengaburkan apakah hipotesis ilmiah yang keliru atau implementasi kodenya yang cacat (menyebabkan hipotesis potensial terbuang sia-sia), sementara skor agregat yang rendah menyembunyikan sub-komponen program berkinerja tinggi. SwarmRSI memperkenalkan Shared Research Graph G_t, Feedback-Guided Swarm Mutation (H-mutation vs P-mutation), Complementary Swarm Recombination (Rebase dan Crossover berbasis keunggulan per-instance), serta Recursive Swarm Evolution bertenaga Discounted-UCB Index terintegrasi tekanan permintaan tak terpenuhi (saturated request pressure). Teruji pada OpenProblems (skor 76.2 vs 67.1 TusoAI), NatureBench 90 tugas ilmiah (Match-SOTA 44.4% vs 23.3% Claude Code, +21.1 pp), dan MLE-Bench Lite (81.8% Any-Medal rate) dengan efisiensi token superior.
SwarmRSI (arXiv:2610.20431): Recursive Self-Improvement through Evolving Scientific Agent Swarm, Feedback-Guided Mutation, dan Solusi Dead-End Research pada AI Ilmiah
Bagaimana swarm agen AI ilmiah memecahkan dilema mendasar Recursive Self-Improvement (RSI): membedakan kegagalan hipotesis versus kegagalan sintaksis/kode, menyelamatkan hipotesis brilian dari pembuangan prematur, dan merekayasa rekombinasi komponen modular lintas agen dengan Discounted-UCB Index.
Executive Summary: Paradigma Baru Recursive Self-Improvement AI 2026
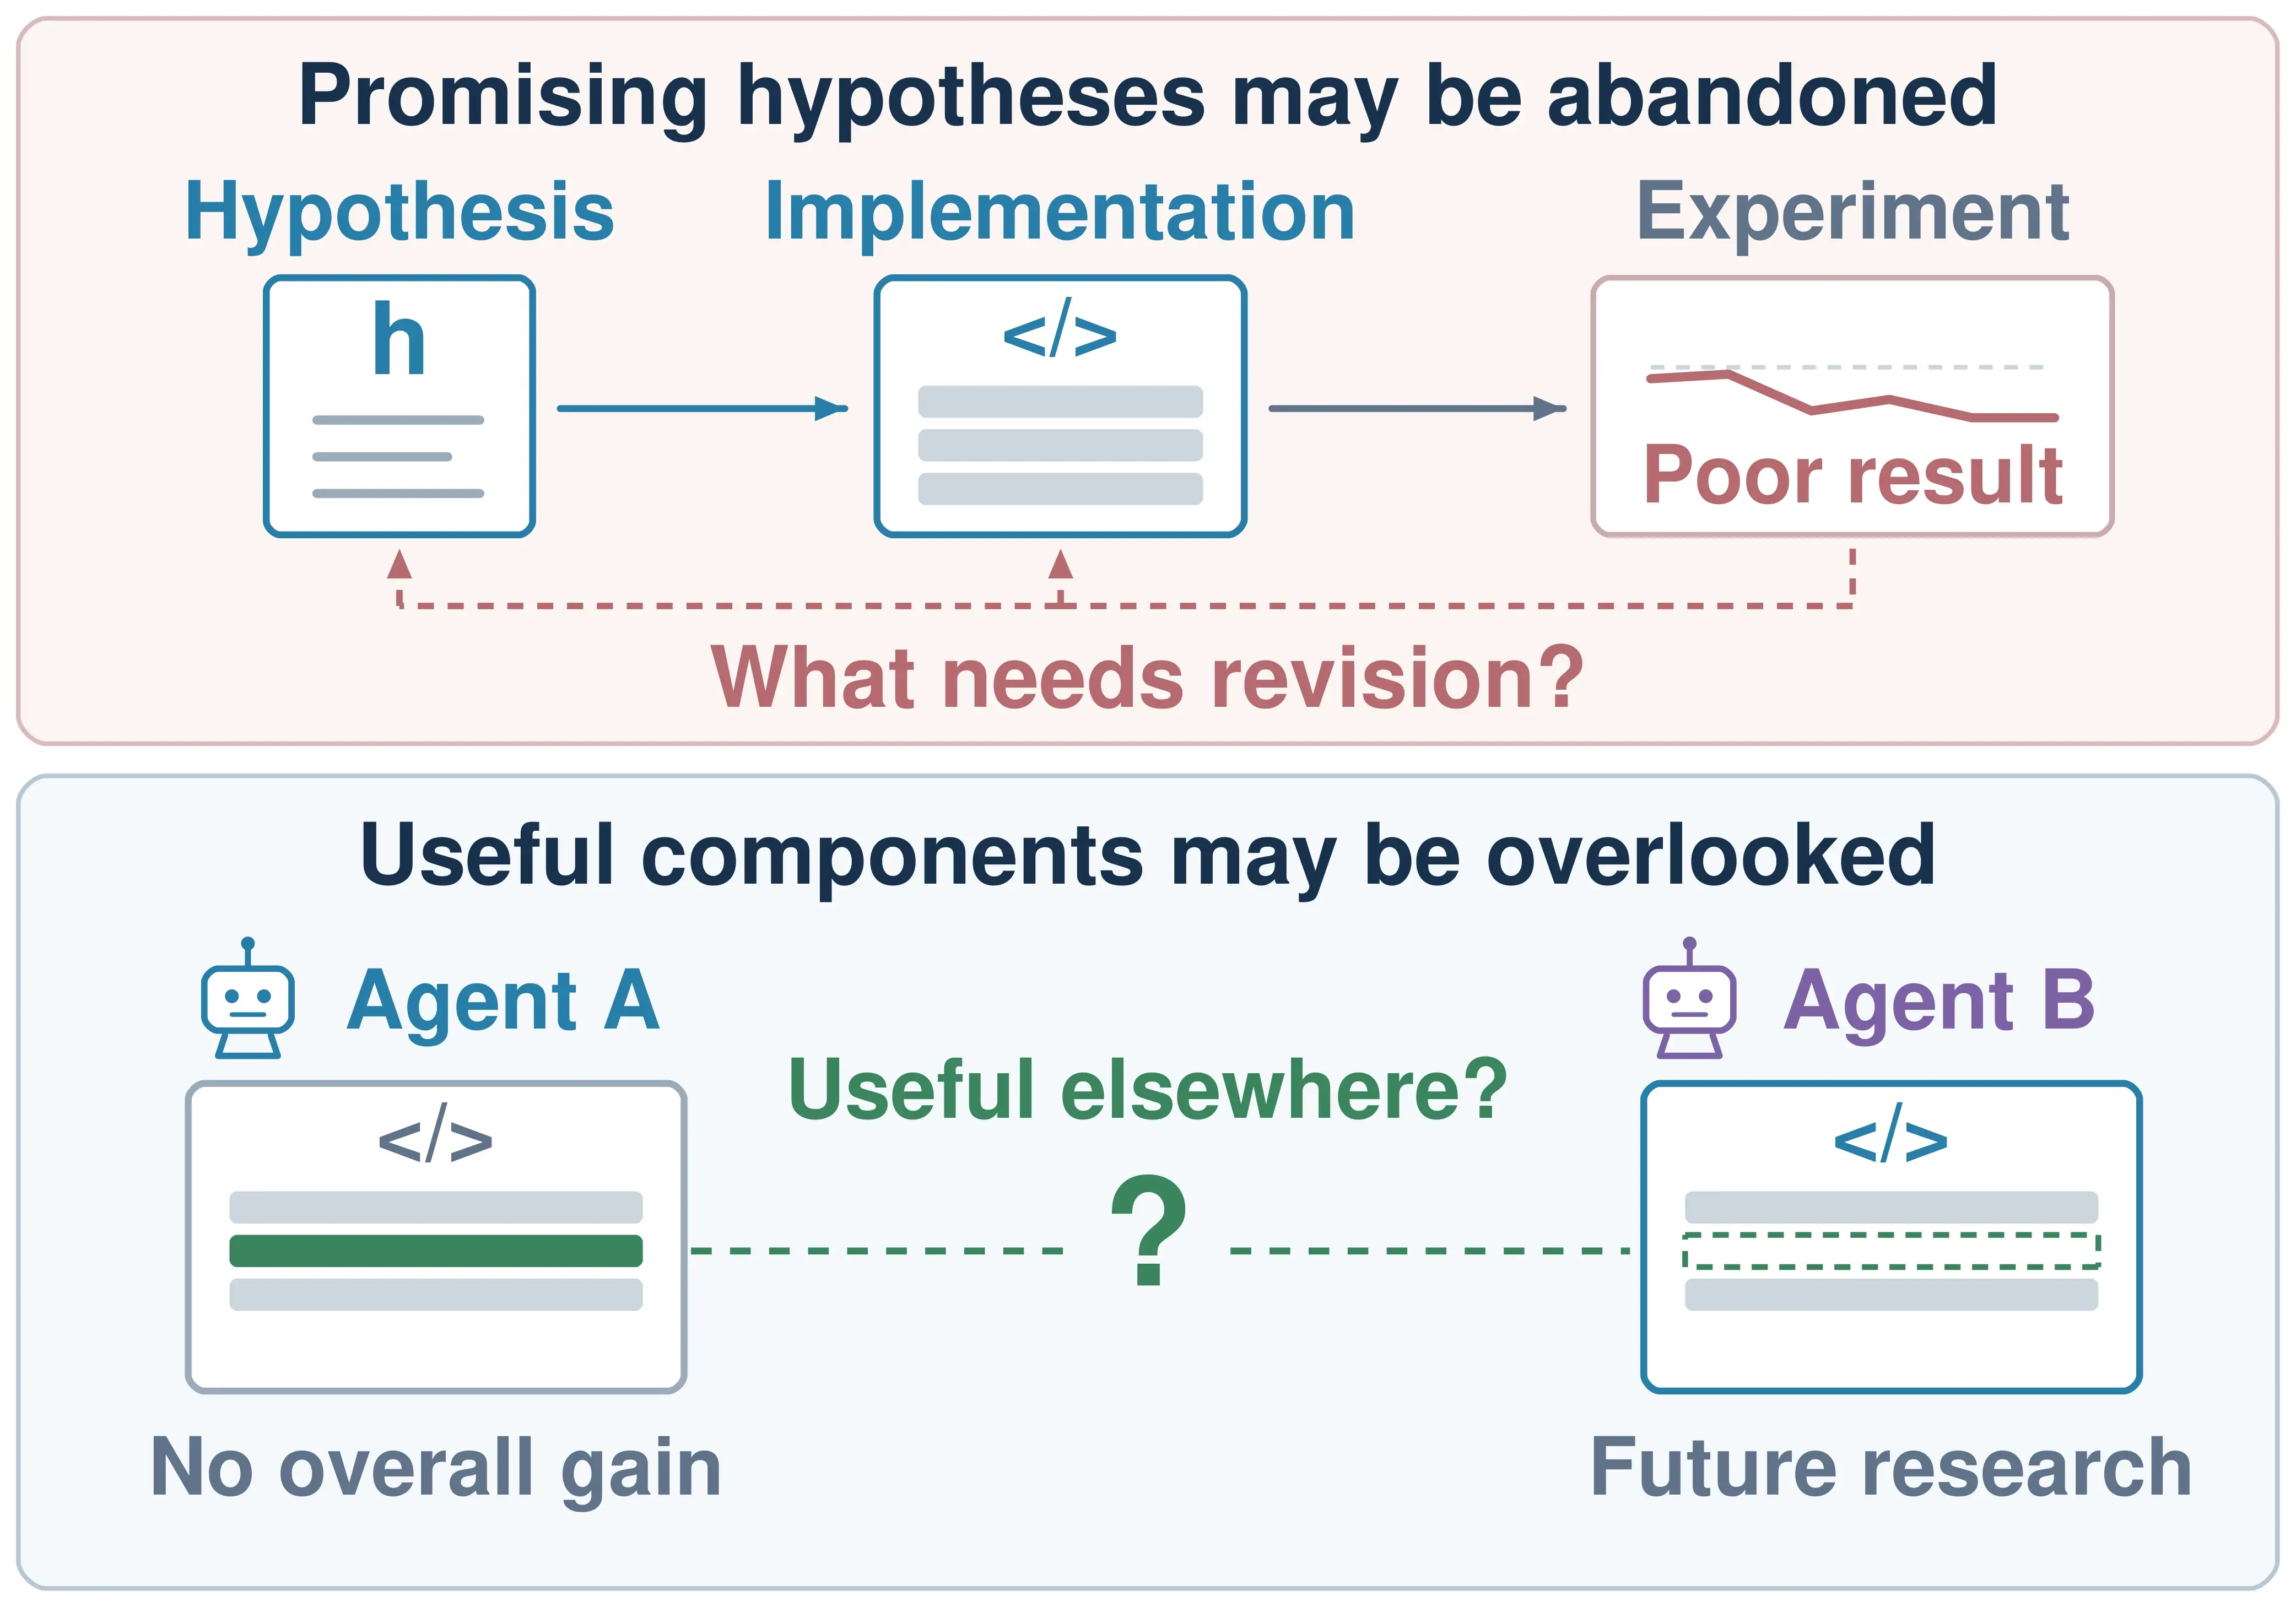
- Dilema Klasik RSI Ilmiah: Dalam agen ilmiah otomatis tradisional (seperti AIDE, Arbor, MLEvolve), kegagalan run eksperimen tidak memberikan sinyal apakah arah riset/hipotesis yang keliru ataukah implementasi kodenya yang buggy. Akibatnya, hipotesis teoritis yang berpotensi merevolusi benchmark sering kali langsung ditinggalkan (abandoned) hanya karena bug periferal kecil.
- Opasitas Skor Agregat: Program yang mendapatkan skor akhir rendah di mata evaluasi global sering kali memiliki sub-komponen data cleaning, fitur rekayasa, atau optimasi kernel yang sangat superior untuk subset tugas tertentu. Pada sistem monolitik, seluruh kode tersebut dibuang ke tong sampah.
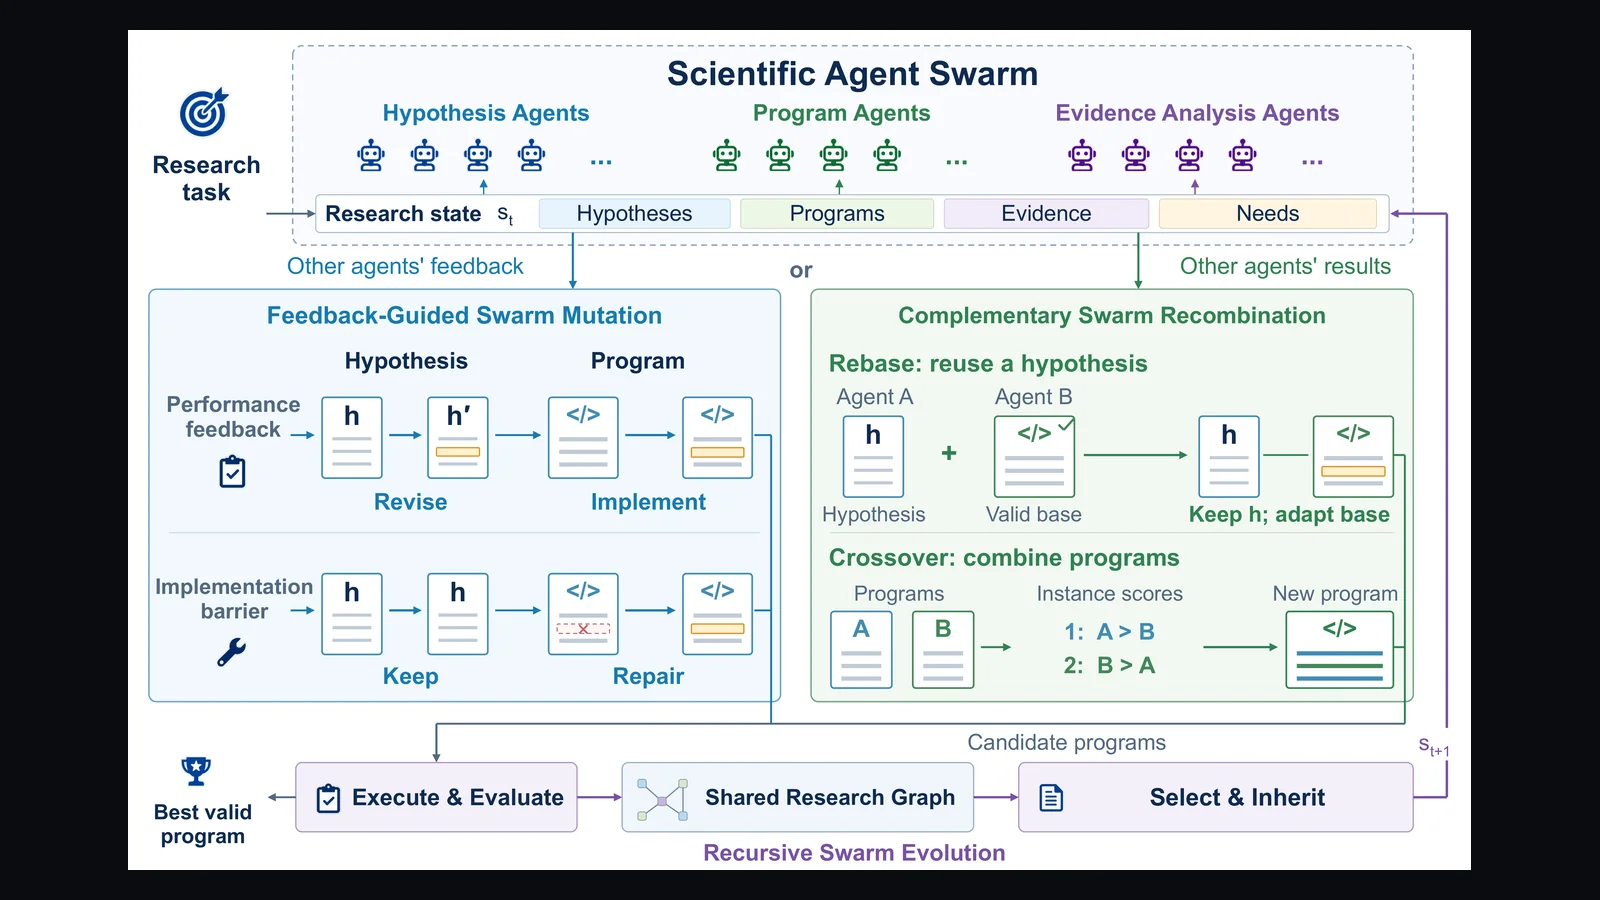
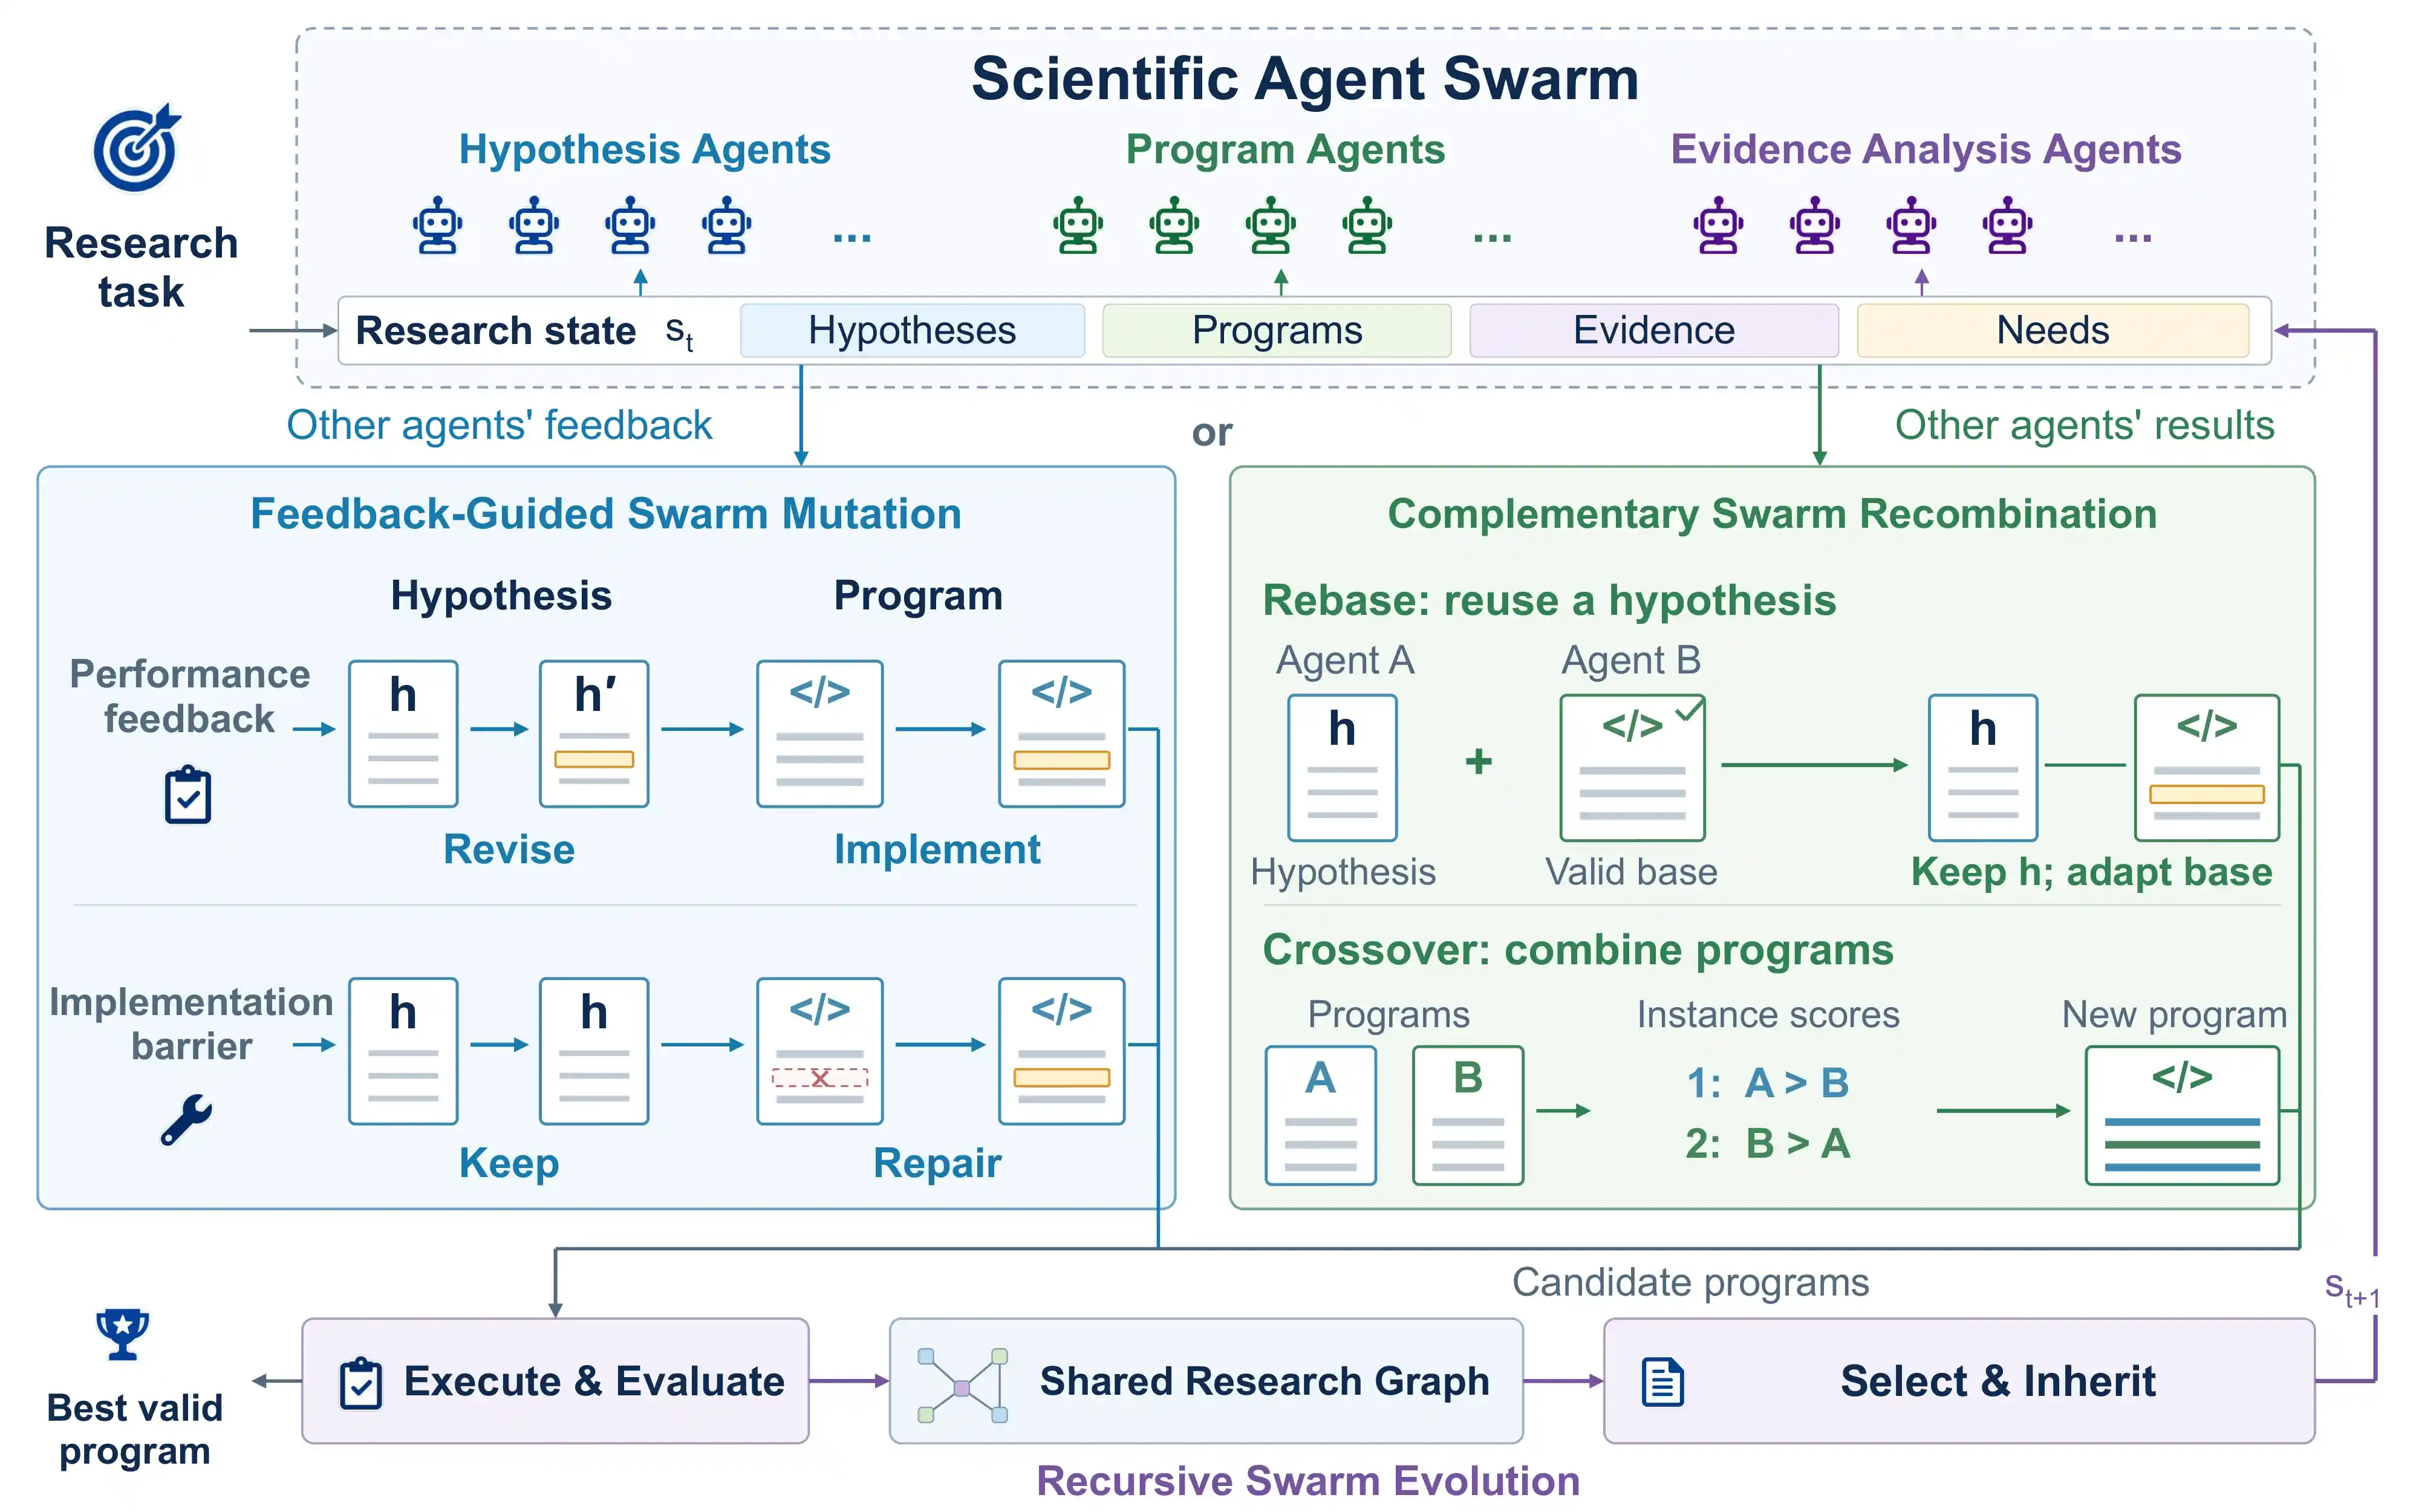
- Trinitas Arsitektur SwarmRSI: (1) Feedback-Guided Swarm Mutation (memisahkan H-mutation untuk pergeseran hipotesis dan P-mutation untuk reparasi implementasi kode); (2) Complementary Swarm Recombination (Rebase hipotesis ke base program agen lain dan Crossover sub-komponen terbaik lintas instance); dan (3) Recursive Swarm Evolution (Graph riset bersama $\mathcal{G}_t$ dengan kontrol UCB dinamis berbobot saturasi request).
- Superioritas Empiris Benchmark: Meraih skor rata-rata 74.2 (DeepSeek-V4-Pro) dan 76.2 (Gemini 3.1 Pro Preview) pada 6 tugas analisis single-cell OpenProblems (mengungguli TusoAI 67.1 dan Human Expert 57.2); mencetak 44.4% Match-SOTA (+21.1 pp di atas Claude Code) pada 90 tugas NatureBench; serta mengunci 81.8% Any-Medal pada MLE-Bench Lite dengan konsumsi token yang jauh lebih hemat.
1. Anatomi Masalah: Mengapa Recursive Self-Improvement Agen Ilmiah Kerap Mengalami Dead-End?
Eksplorasi penemuan ilmiah berbasis AI (Autonomous Scientific Discovery) menuntut sistem untuk merumuskan hipotesis $h$, menerjemahkannya ke dalam kode program $p$, mengeksekusinya di lingkungan komputasi riil, dan mengevaluasi hasilnya terhadap metrik ilmiah $u(p)$. Visi utamanya adalah Recursive Self-Improvement (RSI), di mana agen belajar dari eksperimen masa lalunya sendiri untuk melahirkan terobosan ilmiah baru tanpa supervisi manusia.
Namun, para peneliti dari Huawei Technologies, Leiden University, dan University of Groningen menemukan dua hambatan fundamental yang melumpuhkan sistem agen saat ini:
Entanglement of Hypothesis vs. Implementation
Nilai sebuah hipotesis teoritis sangat bergantung pada bagaimana ia diimplementasikan. Jika sebuah kode melempar pengecualian CUDA Out-of-Memory atau degradasi numerik akibat learning rate, agen monolitik langsung membuang hipotesis tersebut karena metrik $u(p) = 0$. Padahal konsep pemodelannya valid jika diimplementasikan dengan arsitektur memori yang tepat.
Opasitas Komponen pada Skor Global
Sebuah program eksperimental mungkin gagal mengungguli baseline pada rata-rata 10 dataset benchmark. Namun, program tersebut mungkin memecahkan masalah batch effect pada dataset ke-3 dengan presisi luar biasa. Pada sistem evolusi serial, seluruh program tersebut dicap gagal dan tidak pernah dimanfaatkan oleh agen lain.
2. Arsitektur SwarmRSI: Shared Research State Graph $\mathcal{G}_t$
Untuk memecahkan isolasi tersebut, SwarmRSI mengorganisasikan agen-agen ilmiah ke dalam struktur swarm terdistribusi yang terhubung ke satu graf status riset bersama (Shared Research State Graph) $\mathcal{G}_t$.
Setiap langkah riset $t$ tidak lagi dimulai dari nol atau sekadar prompt memory linier, melainkan mengekstrak tuple status:
Di mana $\mathcal{H}_t$ adalah kumpulan hipotesis aktif, $\mathcal{P}_t$ adalah himpunan program executable valid, $\mathcal{E}_t$ adalah bukti eksperimental (output eksekusi, log trace, metrik per-instance), dan yang terpenting: $\mathcal{U}_t$ adalah Unresolved Research Needs (kebutuhan implementasi yang belum terselesaikan, seperti butuh optimasi latensi, butuh loss function alternatif, dsb).
3. Feedback-Guided Swarm Mutation: Memisahkan H-Mutation dan P-Mutation
Inovasi pertama SwarmRSI dalam mencegah hilangnya ide potensial adalah memisahkan mutasi menjadi dua dimensi orthogonal:
H-Mutation (Hypothesis Revision)
Dijalankan ketika sebuah program berhasil dieksekusi tanpa error teknis namun menunjukkan fluktuasi kinerja antar instance/dataset. Rencana revisi $\delta_t$ berfokus pada reposisi mekanisme pemodelan teoritis:
P-Mutation (Program Repair / Implementation Refinement)
Dijalankan saat audit mendeteksi kegagalan eksekusi (runtime crash, format mismatch, OOM) atau intervensi kode yang tidak terealisasi secara semantik. Hipotesis dipertahankan secara utuh ($ ilde{h}_t = h_t$), sementara agen pemrograman melakukan perbaikan bedah (surgical repair) pada implementasi:
Dengan mekanisme ini, hipotesis yang brilian tidak akan dibuang hanya karena adanya bug kompilasi atau kesalahan nama argumen fungsi.
4. Complementary Swarm Recombination: Rebase dan Instance-Aware Crossover
Dalam penelitian ilmiah, kemajuan sering kali dicapai bukan dengan merancang segalanya dari nol, melainkan dengan meminjam fondasi solid dari tim lain. SwarmRSI memformalkan prinsip ini ke dalam dua operator rekombinasi:
A. Hypothesis Rebase
Jika sebuah hipotesis $h_t$ memiliki kendala implementasi yang macet (unresolved implementation needs), agen menelusuri graf $\mathcal{G}_t$ untuk mencari program basis $b_t$ yang dikembangkan oleh agen lain yang memiliki mekanisme cocok. Operasi Rebase memindahkan hipotesis $h_t$ untuk diimplementasikan di atas $b_t$:
B. Program Crossover Berdasarkan Keunggulan Per-Instance
Alih-alih crossover acak pada string kode, SwarmRSI membandingkan profil utilitas per-subtugas $u_k(p)$. Program donor $\mathcal{D}(p_t)$ dipilih dari program-program valid yang mengalahkan program induk $p_t$ pada setidaknya satu instance $k$, diurutkan berdasarkan keunggulan terbesar $\Delta_t(d)$:
Program anakan baru mewarisi sub-rutin donor pada instance di mana donor tersebut menang, dan mempertahankan komponen induk di area lainnya.
5. Recursive Swarm Evolution: Penjadwalan Dinamis dengan Discounted-UCB Index
Kapan swarm harus mengeksplorasi hipotesis baru ($H$), dan kapan harus mereparasi/mengoptimalkan kode program ($P$)? Jika penjadwalan dilakukan secara statis (misal bergantian H-P-H-P), agen akan membuang komputasi saat salah satu jalur mengalami kebuntuan.
SwarmRSI mempertahankan Hypothesis Frontier $\mathcal{F}_H$ dan Program Frontier $\mathcal{F}_P$. Keputusan pemilihan frontier $f \in \{H, P\}$ dikendalikan oleh indeks Discounted-UCB yang diperkaya dengan Saturated Request Pressure $\psi_f$:
Komponen perumus indeks:
- $\hat{\mu}_f = G_f / C_f$: Keberhasilan mutakhir (reward gain per unit token cost), terdiskon dengan faktor $\rho = 0.9$ agar peka terhadap tren eksperimen terkini.
- $\beta \sqrt{\frac{\log(\dots)}{N_f}}$: Bonus eksplorasi bandit untuk frontier yang jarang dipilih.
- $\gamma \psi_f$: Tekanan permintaan jenuh $\psi_f = \min(U_f, K) / K$ (dengan $K=4$). Ketika eksekusi program banyak melempar permintaan perbaikan (deepen request), tekanan pada frontier $P$ melonjak drastis, memicu swarm untuk memprioritaskan perbaikan bug sebelum merumuskan hipotesis baru.
6. Hasil Evaluasi Empiris Komprehensif
SwarmRSI diuji secara ekstensif pada 3 benchmark rekayasa sains dan machine learning berskala besar menggunakan backbone DeepSeek-V4-Pro dan Gemini 3.1 Pro Preview.
Tabel 1: Evaluasi pada 6 Tugas Analisis Single-Cell OpenProblems
| Metode | Backbone | Denoise | Label | Batch | SVG | Decomp | Visual | Rata-Rata (Avg) |
|---|---|---|---|---|---|---|---|---|
| Human Expert | Task-specific | 28.0 | 85.0 | 71.0 | 66.0 | 49.0 | 44.0 | 57.2 |
| Biomni | Claude 4 Sonnet | 16.0 | 89.0 | 82.0 | 16.0 | 53.0 | 35.0 | 48.5 |
| ChatGPT | GPT-5 | 3.0 | 81.0 | 83.0 | 60.0 | 74.0 | 38.0 | 56.5 |
| AIDE | DeepSeek-V4-Pro | 27.4 | 70.6 | 78.0 | 72.8 | 46.1 | 39.8 | 55.8 |
| TusoAI | DeepSeek-V4-Pro | 31.5 | 58.7 | 79.5 | 79.0 | 84.1 | 69.8 | 67.1 |
| SwarmRSI (Ours) | DeepSeek-V4-Pro | 33.6 | 74.2 | 82.5 | 83.9 | 86.0 | 84.8 | 74.2 |
| SwarmRSI (Ours) | Gemini 3.1 Pro Preview | 40.2 | 80.7 | 78.8 | 87.8 | 83.4 | 86.4 | 76.2 |
Tabel 2: Performa NatureBench (90 Tugas Ilmiah Lintas 6 Domain)
| Sistem Agen | Model Backbone | Surpass-SOTA (%) | Match-SOTA (%) |
|---|---|---|---|
| Claude Code | DeepSeek-V4-Pro | 4.4% | 23.3% |
| Codex | GPT-5.5 | 4.4% | 25.6% |
| AIDE | DeepSeek-V4-Pro | 10.0% | 27.8% |
| Arbor | DeepSeek-V4-Pro | 12.2% | 36.7% |
| SwarmRSI (Ours) | DeepSeek-V4-Pro | 15.6% | 44.4% |
| SwarmRSI (Ours) | Gemini 3.1 Pro Preview | 14.4% | 44.4% |
7. Studi Ablasi: Komponen Mana yang Paling Krusial?
Melalui uji ablasi terkontrol pada 90 tugas NatureBench (Tabel 3 paper), peneliti mengisolasi kontribusi masing-masing mekanisme:
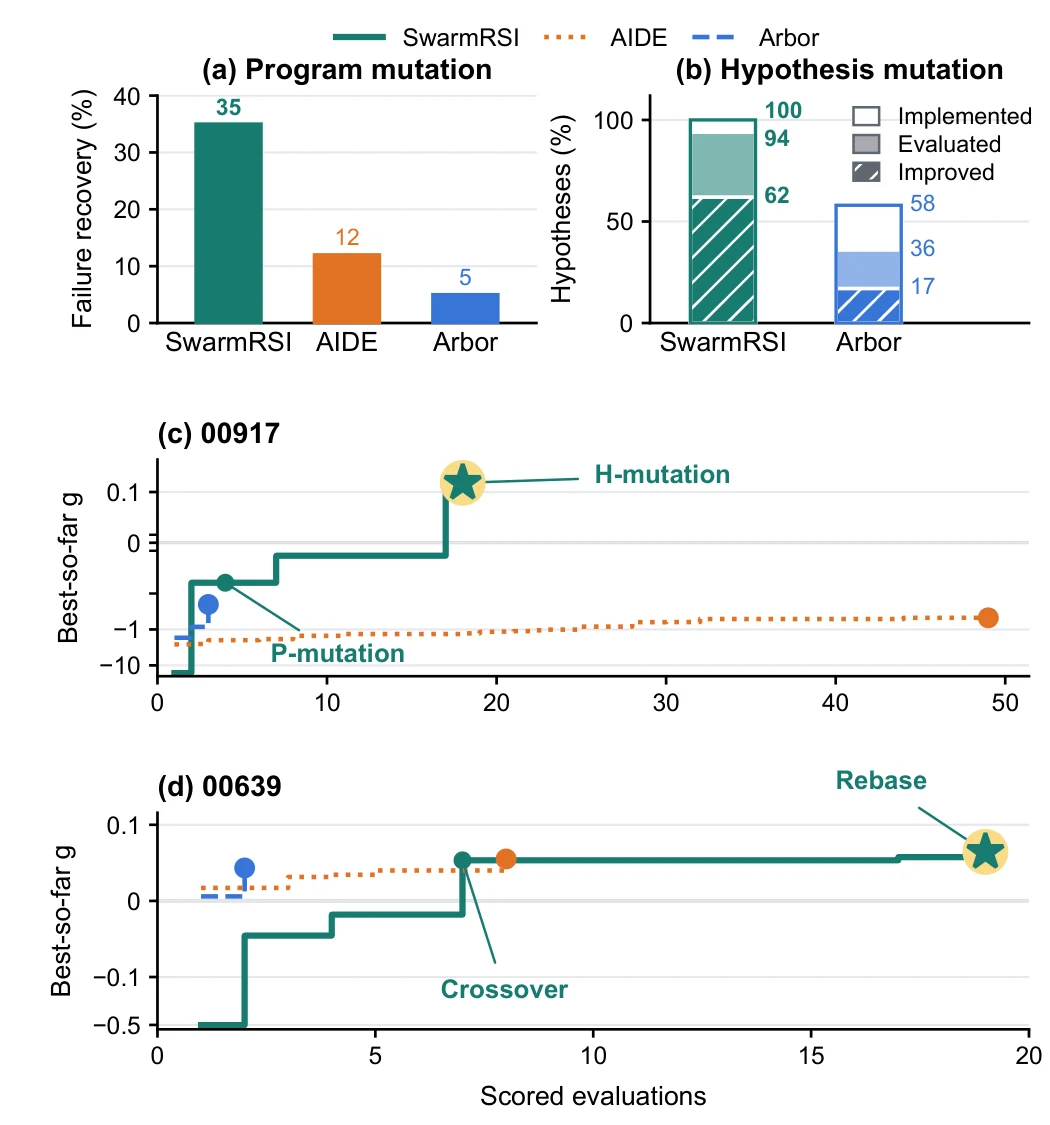
- Menghapus P-mutation: Match-SOTA anjlok dari 44.4% menjadi 31.1% (-13.3 pp). Ini membuktikan bahwa kemampuan mereparasi kode tanpa mengubah hipotesis adalah pilar paling vital dalam menjaga stabilitas pencarian.
- Menghapus H-mutation: Match-SOTA turun menjadi 34.4% (-10.0 pp). Memperbaiki kode saja tanpa bisa mengevolusi hipotesis akan menyebabkan agen terjebak di local minima algoritma.
- Menghapus Dynamic H/P Selection (Diganti Alternasi Statis): Match-SOTA merosot ke 35.6% dan mean gain $g$ mengalami kejatuhan terdalam dari 12.8 ke 4.6. Alokasi komputasi yang adaptif terhadap request pressure terbukti menjadi pembeda utama antara agen cerdas dan brute-force loop.
- Menghapus Recombination (Rebase & Crossover): Surpass-SOTA terpangkas separuh dari 15.6% ke 7.8%, membuktikan bahwa solusi ilmiah terobosan memerlukan sintesis komponen lintas agen.
8. Arsitektur Kode Produksi: SwarmRSI Controller dalam TypeScript
Berikut adalah implementasi clean-architecture dari controller SwarmRSI yang mengintegrasikan status graph $\mathcal{G}_t$, Discounted-UCB scheduling, dan pemilih donor crossover:
// Production Implementation: SwarmRSI (Recursive Self-Improvement Scientific Swarm Controller)
// Berdasarkan formulasi formal arXiv:2610.20431 (Huawei Technologies, Leiden Univ, Univ of Groningen)
// Mengimplementasikan: Shared Research State Graph G_t, Feedback-Guided H/P Mutator,
// Rebase & Instance-Aware Crossover Recombiner, serta Discounted-UCB Index Scheduling.

export interface ScientificHypothesis {
  id: string;
  rationale: string;
  modelingMechanism: string;
  targetInstances: string[];
  createdStep: number;
}

export interface ScientificProgram {
  id: string;
  hypothesisId: string;
  parentProgramId?: string;
  codeSource: string;
  perInstanceUtility: Record; // u_k(p)
  aggregateUtility: number;                   // u(p)
  runtimeAudit: {
    isSyntaxValid: boolean;
    executedSuccessfully: boolean;
    hasStaticReferences: boolean;
    divergentOutputs: boolean;
  };
}

export interface ExecutionRecord {
  step: number;
  testedHypothesis: ScientificHypothesis;
  parentProgram?: ScientificProgram;
  candidateProgram: ScientificProgram;
  outcomeUtility: number;
  auditPassed: boolean;
  unresolvedRequests: Array<'deepen' | 'broaden' | 'rebase_incumbent'>;
}

export interface FrontierStatistics {
  discountedSelectionCount: number; // N_f
  discountedRewardGains: number;    // G_f
  discountedCostTokens: number;     // C_f
  waitingEligibleTurns: number;     // W_f
}

export class SwarmRSIController {
  private researchGraph: ExecutionRecord[] = [];
  private hypothesisFrontier: Map = new Map();
  private programFrontier: Map = new Map();
  private incumbentProgram: ScientificProgram | null = null;

  // Hyperparameters sesuai Tabel 4 & Algoritma 1 paper arXiv:2610.20431
  private readonly rho = 0.9;     // Discount factor
  private readonly beta = 0.5;    // Exploration weight
  private readonly gamma = 0.25;  // Request-pressure weight
  private readonly K_sat = 4;     // Saturated request ceiling
  private readonly waitThreshold = 8; // W eligible turns

  private hStats: FrontierStatistics = { discountedSelectionCount: 0, discountedRewardGains: 0, discountedCostTokens: 0, waitingEligibleTurns: 0 };
  private pStats: FrontierStatistics = { discountedSelectionCount: 0, discountedRewardGains: 0, discountedCostTokens: 0, waitingEligibleTurns: 0 };

  constructor(initialDrafts: ScientificProgram[]) {
    for (const prog of initialDrafts) {
      this.programFrontier.set(prog.id, prog);
      if (!this.incumbentProgram || prog.aggregateUtility > this.incumbentProgram.aggregateUtility) {
        this.incumbentProgram = prog;
      }
    }
  }

  /**
   * 1. Dynamic H/P Selection Controller via Discounted-UCB Index
   * S_f = \hat{\mu}_f + \beta * sqrt(ln(1 + N_H + N_P) / N_f) + \gamma * \psi_f
   */
  public selectNextFrontier(unresolvedHRequests: number, unresolvedPRequests: number): 'H' | 'P' {
    // Priority Rule 1: Waiting turns exceeded threshold W
    if (this.hStats.waitingEligibleTurns >= this.waitThreshold) return 'H';
    if (this.pStats.waitingEligibleTurns >= this.waitThreshold) return 'P';

    // Priority Rule 2: Untried frontiers
    if (this.hStats.discountedSelectionCount === 0) return 'H';
    if (this.pStats.discountedSelectionCount === 0) return 'P';

    const totalSelections = this.hStats.discountedSelectionCount + this.pStats.discountedSelectionCount;
    const psi_H = Math.min(unresolvedHRequests, this.K_sat) / this.K_sat;
    const psi_P = Math.min(unresolvedPRequests, this.K_sat) / this.K_sat;

    const mu_H = this.hStats.discountedCostTokens > 0 ? this.hStats.discountedRewardGains / this.hStats.discountedCostTokens : 0;
    const mu_P = this.pStats.discountedCostTokens > 0 ? this.pStats.discountedRewardGains / this.pStats.discountedCostTokens : 0;

    const score_H = mu_H + this.beta * Math.sqrt(Math.log(1 + totalSelections) / this.hStats.discountedSelectionCount) + this.gamma * psi_H;
    const score_P = mu_P + this.beta * Math.sqrt(Math.log(1 + totalSelections) / this.pStats.discountedSelectionCount) + this.gamma * psi_P;

    if (score_H >= score_P) {
      this.hStats.waitingEligibleTurns = 0;
      this.pStats.waitingEligibleTurns += 1;
      return 'H';
    } else {
      this.pStats.waitingEligibleTurns = 0;
      this.hStats.waitingEligibleTurns += 1;
      return 'P';
    }
  }

  /**
   * 2. Complementary Swarm Recombination: Crossover Donors Selection
   * Memilih sub-komponen program donor berdasarkan max instance advantage Delta_t(d)
   */
  public selectCrossoverDonors(parent: ScientificProgram): ScientificProgram[] {
    const donors: Array<{ program: ScientificProgram; maxAdvantage: number }> = [];

    for (const [id, candidate] of this.programFrontier.entries()) {
      if (id === parent.id) continue;
      let maxAdv = 0;
      for (const [subtaskKey, util] of Object.entries(candidate.perInstanceUtility)) {
        const parentUtil = parent.perInstanceUtility[subtaskKey] || 0;
        if (util > parentUtil) {
          const diff = util - parentUtil;
          if (diff > maxAdv) maxAdv = diff;
        }
      }
      if (maxAdv > 0) {
        donors.push({ program: candidate, maxAdvantage: maxAdv });
      }
    }

    donors.sort((a, b) => b.maxAdvantage - a.maxAdvantage);
    return donors.slice(0, 2).map(d => d.program);
  }

  /**
   * 3. State Update & Research Record Retention
   */
  public registerAttempt(record: ExecutionRecord, tokenCost: number, chosenFrontier: 'H' | 'P') {
    this.researchGraph.push(record);
    const prevIncumbent = this.incumbentProgram?.aggregateUtility || 0;
    const gain = Math.min(1.0, Math.max(0, record.outcomeUtility - prevIncumbent));
    const normalizedCost = Math.max(1, tokenCost / 1000);

    if (record.candidateProgram.aggregateUtility > prevIncumbent && record.auditPassed) {
      this.incumbentProgram = record.candidateProgram;
      this.programFrontier.set(record.candidateProgram.id, record.candidateProgram);
    }

    // Update frontier statistics with discount rho = 0.9
    const updateStats = (stats: FrontierStatistics, isSelected: boolean) => {
      stats.discountedSelectionCount = this.rho * stats.discountedSelectionCount + (isSelected ? 1 : 0);
      stats.discountedRewardGains = this.rho * stats.discountedRewardGains + (isSelected ? gain : 0);
      stats.discountedCostTokens = this.rho * stats.discountedCostTokens + (isSelected ? normalizedCost : 0);
    };

    updateStats(this.hStats, chosenFrontier === 'H');
    updateStats(this.pStats, chosenFrontier === 'P');
  }
}
9. Rekomendasi Rekayasa Sistem Agen AI 2026: Implikasi Strategis
Makalah SwarmRSI meletakkan standar baru bagi bagaimana para arsitek AI dan tim riset enterprise membangun agen otonom:
- Jangan Pernah Membuang Trajektori Negatif: Eksperimen yang melempar error atau menghasilkan skor buruk bukan sampah komputasi; itu adalah audit evidence yang memberi tahu agen lain jalur mana yang tidak boleh diulang dan komponen mana yang perlu direparasi.
- Pisahkan Logika Ideasi dari Logika Implementasi: Agen perencana (Planner) dan agen koder (Coder) harus memiliki siklus hidup evaluasi terpisah. Kesalahan sintaksis tidak boleh membatalkan kelayakan hipotesis.
- Manfaatkan Sub-Komponen Modular Lintas Eksekusi: Desain arsitektur agen harus mampu membedah skrip ke dalam modul-modul independen (data loader, loss function, feature extractor) sehingga fungsi yang unggul pada subset data dapat dicangkokkan (crossover) ke program lain.
- Gunakan Saturated Request Pressure untuk Bandit Scheduling: Menghitung UCB murni hanya berdasarkan reward historis adalah kesalahan fatal dalam sistem agen karena reward sering kali sparse (jarang). Memasukkan metrik saturasi permintaan kebutuhan tak terpenuhi ($\psi_f$) memberikan sensitivitas real-time terhadap kemacetan pipeline.
Referensi & Sumber Terverifikasi
- [1]SwarmRSI: Recursive Self-Improvement through Evolving Scientific Agent Swarm(arXiv:2610.20431 [cs.AI, cs.SE, q-bio.QM] — Qianru Meng, Xi Zhang, Konstantinos Papakostas, Congfeng Cao, Wenxiang Hu, Tianyi Lu, Xiao Zhang, Lun Zhou, Zaiqiao Meng, Zhaochun Ren, Xiaohui Yan, Yougang Lyu (Huawei Technologies, Leiden University, University of Groningen))
- [2]NatureBench: Benchmarking AI Agents on 90 Real-World Scientific Computing Tasks Across Six Domains(Nature Machine Intelligence / arXiv:2603.09112 — Wang et al.)
- [3]OpenProblems in Single-Cell Analysis: Continuous Benchmarking and Agentic Evaluation(Nature Methods / OpenProblems Consortium — Luecken et al.)
- [4]MLE-Bench: Evaluating Machine Learning Engineering Capabilities of AI Agents(OpenAI Research / arXiv:2410.07095 — Chan et al.)
- [5]Arbor: Tree-Search Hypothesis Evolution for Autonomous Scientific Discovery(arXiv:2602.14920 — Jin, Zhang et al.)
- [6]AIDE: Automated Iterative Development for Machine Learning Exploration(ICML 2025 / arXiv:2501.12099 — Jiang et al.)
- [7]CoPE: Co-Evolving Acting and Forecasting for Language Agents (arXiv:2610.20597)(NEWSAINT Frontier AI Systems Review / arXiv:2610.20597)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.

Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.

DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.