MLExpert (arXiv:2610.22344): Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering, Windowed Interaction RL (WIRL), dan Kaggle-MLE Factory
Bedah arsitektur riset frontier arXiv:2610.22344 (Shangheng Du et al. — East China Normal University & Shanghai AI Laboratory): Mengapa sistem autonomous machine learning engineering (MLE) berbasis workflow statis dan single-step RL gagal menembus batas long-horizon? MLExpert memperkenalkan model agentic Mixture-of-Experts 35B (~3B active) yang dilatih melalui Hierarchical Agentic SFT (dengan outcome-guided supervision selection untuk memotong tail degradasi) dan Windowed Interaction Reinforcement Learning (WIRL). Alih-alih menunggu seluruh trajektori 12 jam selesai, WIRL mempartisi keputusan ke dalam execution windows antar-eksekusi eksperimen, memberikan shared verifiable reward berbasis medal Kaggle dan local trend, serta menerapkan token-level policy correction untuk asynchronous collection. Pada MLE-Bench Lite, MLExpert melipatgandakan perolehan medali dari 37.9% menjadi 72.7% (Gold 50.0%)—menyamai frontier model tertutup seperti Kimi-K3 dan GLM-5.3—serta mempertahankan 69.7% medal rate pada general-purpose harness Claude Code.
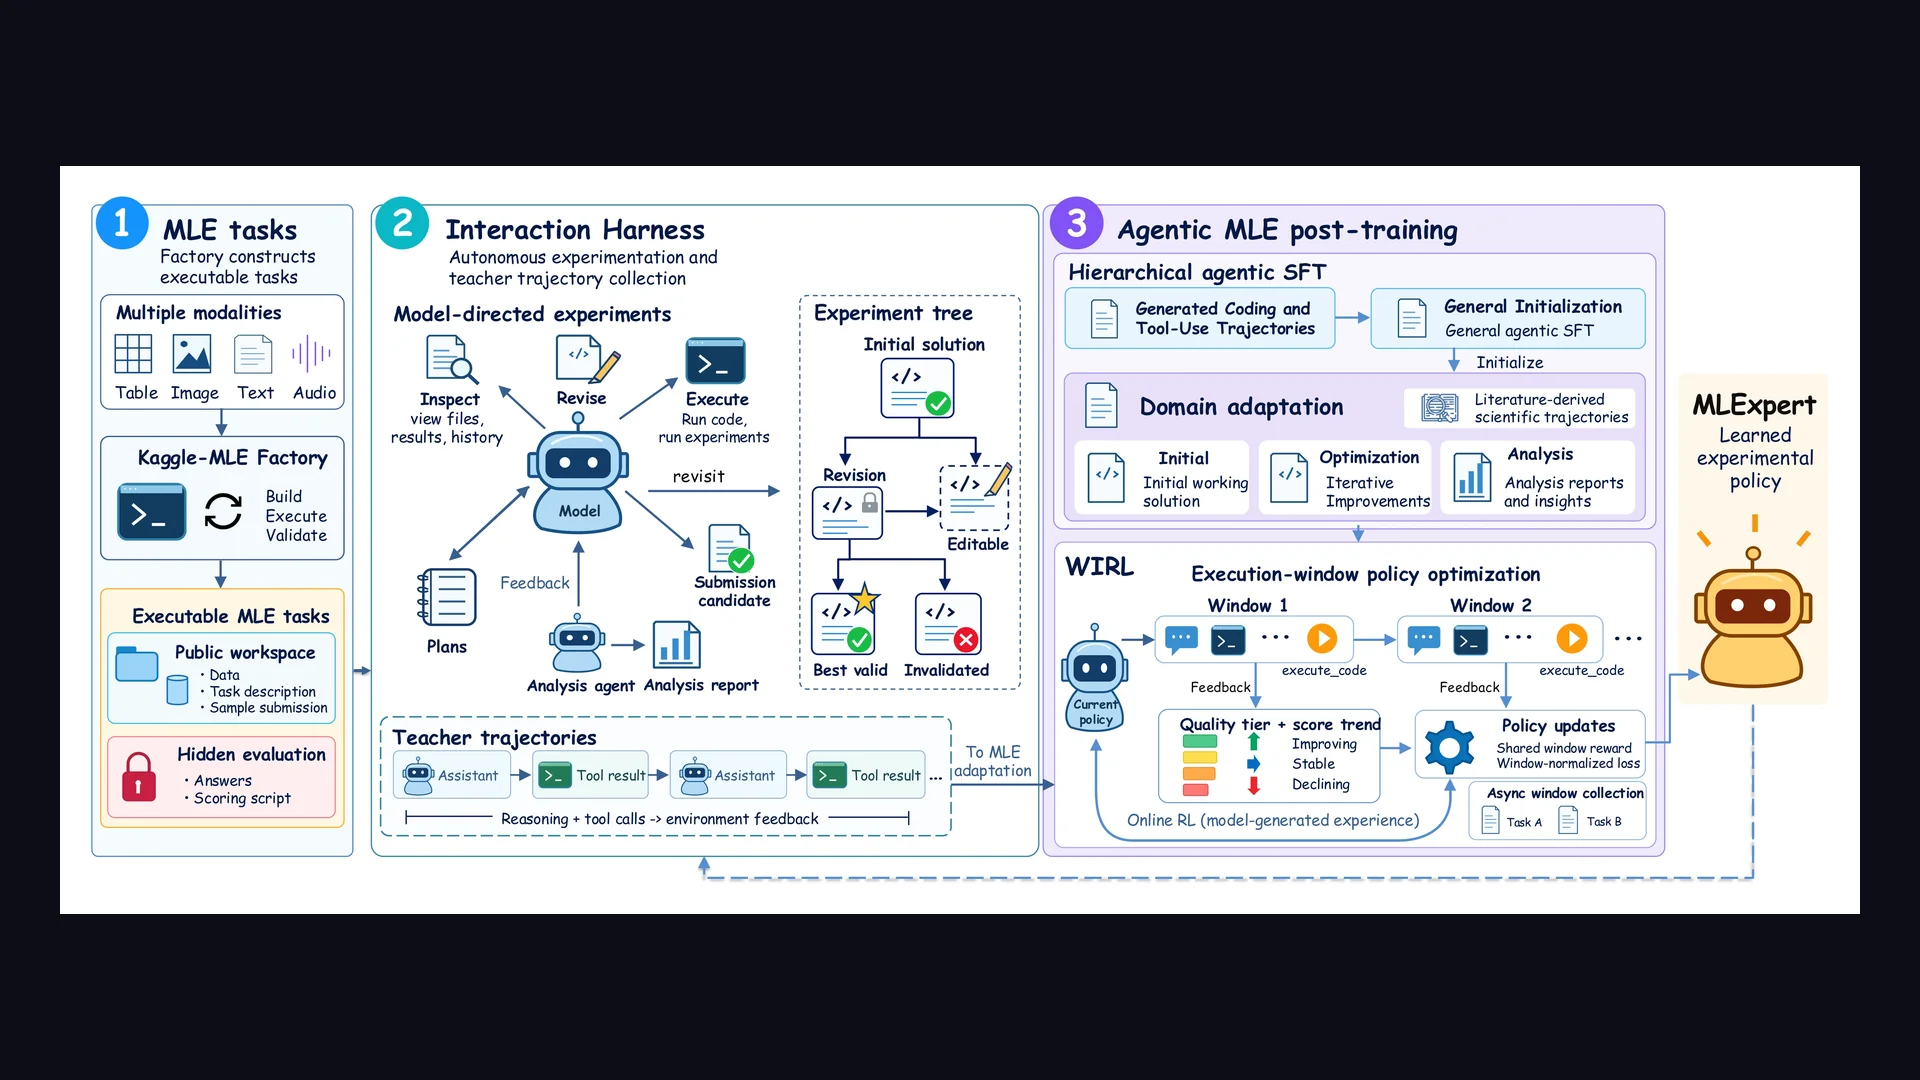
Dalam evolusi agen AI menuju Recursive Self-Improvement (RSI) dan AI for AI (AI4AI), otomatisasi rekayasa pembelajaran mesin (Autonomous Machine Learning Engineering / MLE) merupakan salah satu arena paling menuntut. Berbeda dengan pembuatan kode satu-kali (one-shot generation) atau penyelesaian bug terlokalisasi, MLE menuntut orkestrasi jangka panjang (long-horizon decision making): memahami data tabular heterogen, merancang hipotesis arsitektur, mengeksekusi pipeline training yang memakan waktu berjam-jam, mendiagnosis log error secara mandiri, dan melakukan iterasi berulang hingga mencapai batas konvergensi metrik kompetisi nyata.
Ringkasan Eksekutif Arsitektur
Riset frontier terbaru dari East China Normal University & Shanghai Artificial Intelligence Laboratory (arXiv:2610.22344) merilis MLExpert: model Mixture-of-Experts 35B (~3B active parameters) yang mengungguli seluruh model berukuran setara dan menyamai frontier model raksasa (Kimi-K3, GLM-5.3, GPT-5.5). Inovasi kuncinya berpijak pada dua pilar: Kaggle-MLE Factory yang mengonversi kompetisi riil menjadi 154 task tervalidasi, serta paradigma pelatihan Windowed Interaction Reinforcement Learning (WIRL) yang memecah alokasi kredit RL ke dalam execution window berorientasi eksekusi tanpa menunggu selesainya 12 jam runtime trajektori.
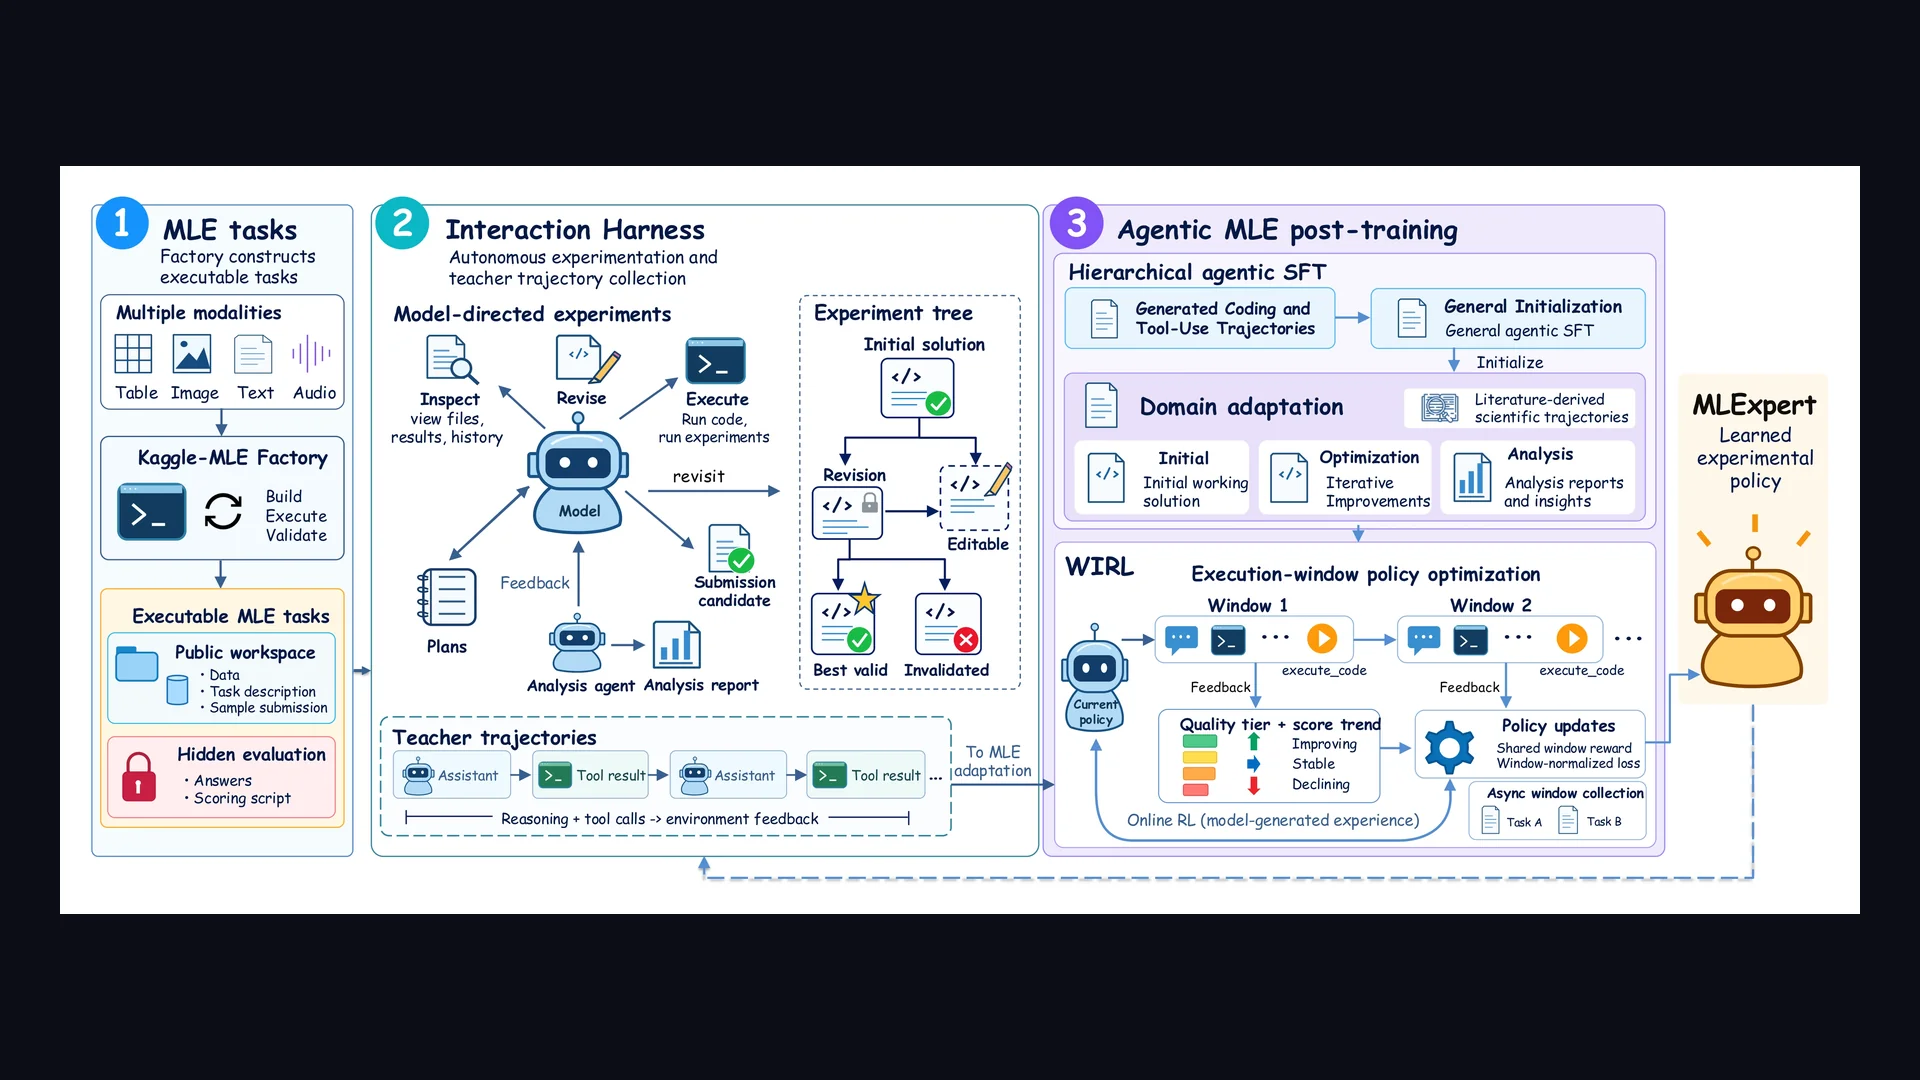
Gambar 1: Ikhtisar Arsitektur MLExpert — Sinergi Kaggle-MLE Factory, Interaction Harness, Hierarchical Agentic SFT, dan Windowed Interaction RL (WIRL).
1. Pergeseran Paradigma: Workflow-Driven vs. Model-Directed Interaction
Sistem autonomous MLE terdahulu seperti AIDE, MLE-Star, dan RD-Agent mengandalkan orkestrasi eksternal berbasis alur kerja (workflow-driven). Dalam paradigma ini, transisi fase—dari eksplorasi data, feature engineering, pemilihan model, hingga hyperparameter tuning—dikunci oleh aturan skrip atau graph orchestration yang kaku. Model LLM hanya difungsikan sebagai "pencatat kode" pada slot-slot tertentu yang telah dialokasikan.
Pendekatan tersebut memiliki kelemahan fatal: ia tidak mampu beradaptasi ketika eksperimen menemui anomali data tak terduga, degradasi akurasi validasi, atau error CUDA out-of-memory (OOM). Sebaliknya, paradigma Model-Directed Interaction yang diadopsi MLExpert membebaskan agen untuk mengatur jalannya riset secara otonom:
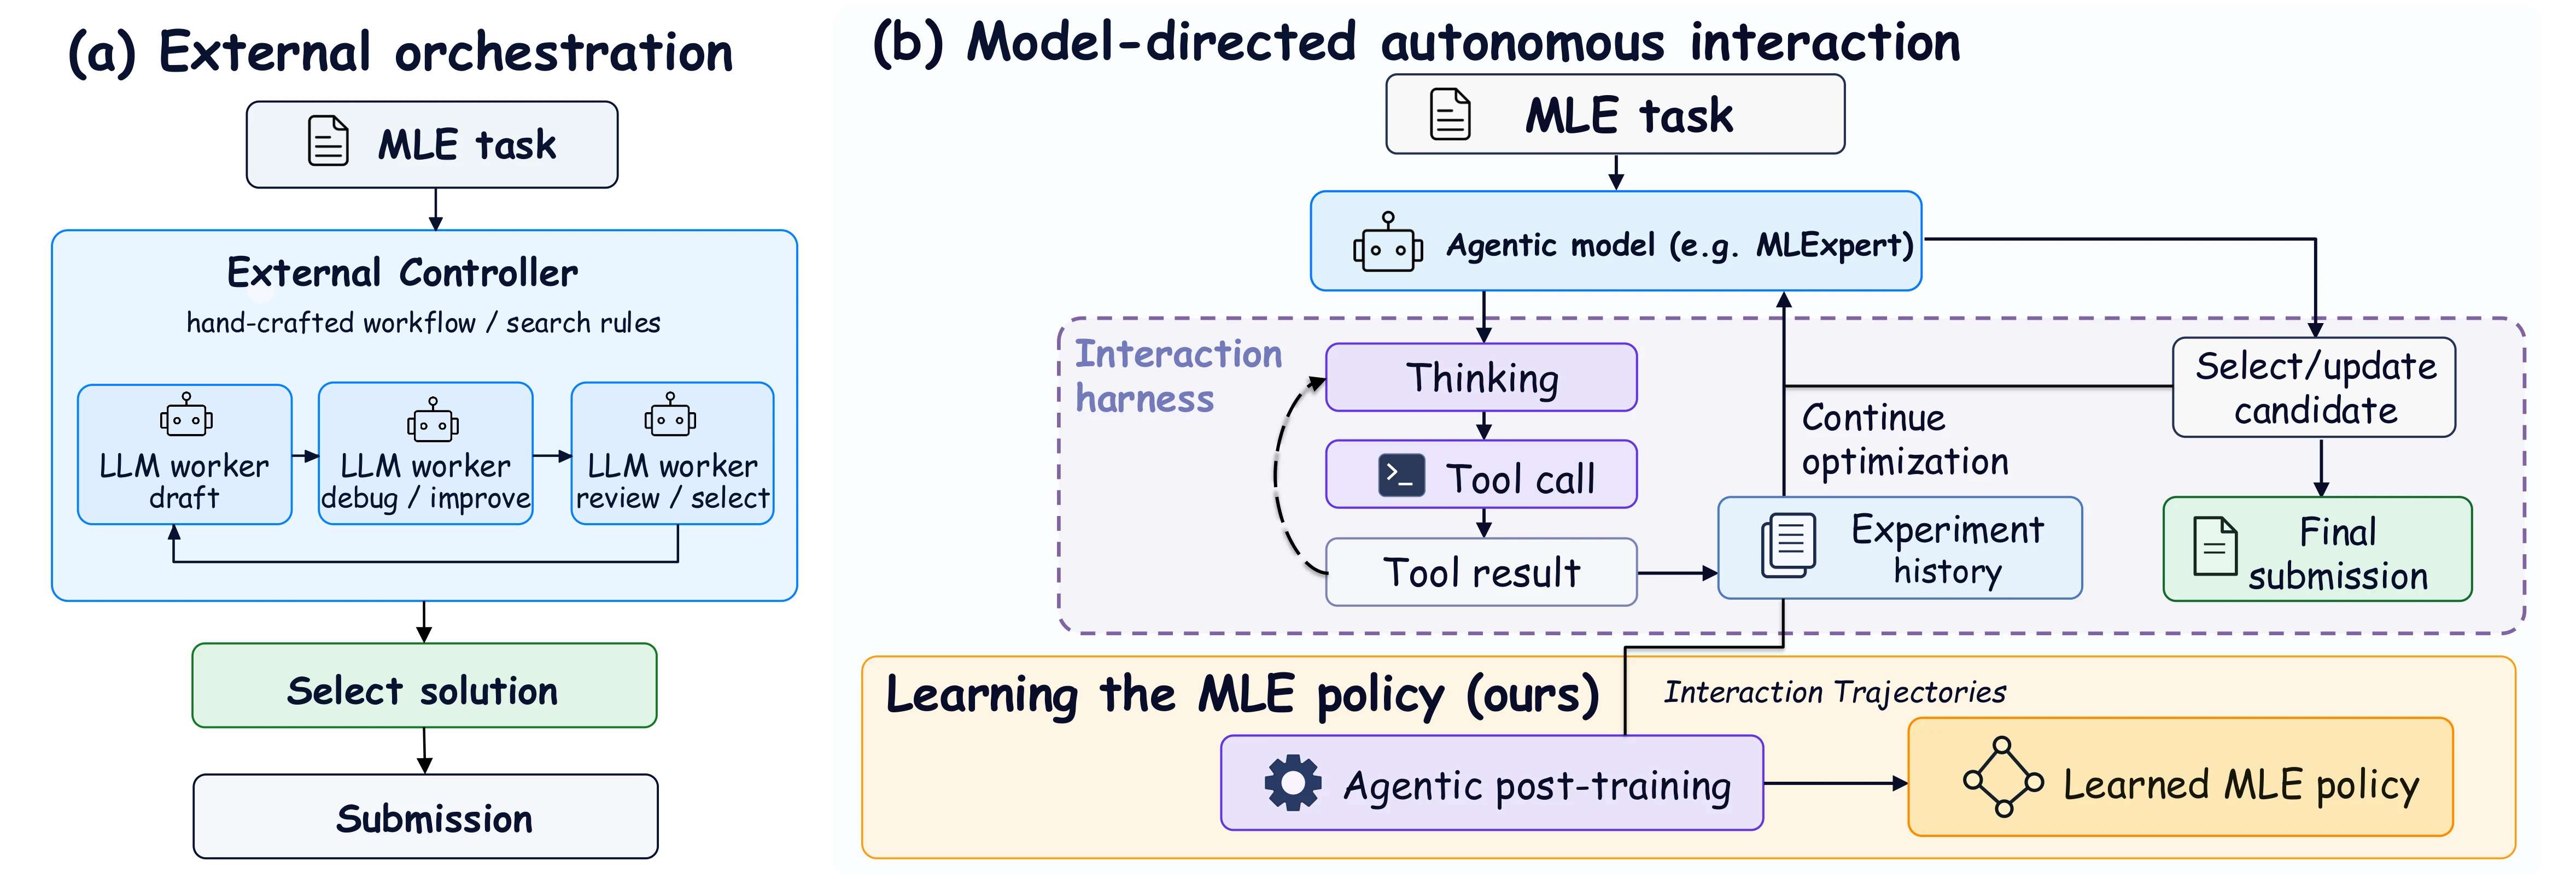
Gambar 2: (a) External Workflow-Driven: Alur kaku dengan aturan transisi manual. (b) Model-Directed Interaction: Model secara otonom mengontrol backtracking, revisi, dan arah optimasi berbasis umpan balik eksekusi.
- Workspace State Graph: Status eksperimen disimpan dalam simpul solusi (solution nodes) yang memuat kandidat source code, execution log, dan metrik validasi. Relasi parent-child membentuk pohon eksperimen yang memungkinkan model melakukan penelusuran kembali (backtracking) jika cabang pengujian mengalami divergensi.
- ReAct Loop Berkelanjutan: Agen mengontrol seluruh siklus eksperimen melalui toolset terstandar:
execute_codeuntuk meluncurkan training di latar belakang,analyzeuntuk mendelegasikan komputasi data berat ke sub-agen analis, danupdate_answeruntuk memperbarui checkpoint kandidat terbaik yang akan dievaluasi pada private leaderboard.
2. Kaggle-MLE Factory: Otomatisasi Sintesis Task Eksekusi Nyata
Salah satu kendala terbesar dalam melatih agen MLE adalah heterogenitas data kompetisi: format input yang tidak seragam, kebocoran label (data leakage), dan ketiadaan evaluator offline otomatis. Shanghai AI Lab merancang Kaggle-MLE Factory—sebuah pipeline multi-agen end-to-end yang menyaring 11.649 kompetisi Meta-Kaggle menjadi lingkungan latihan yang terisolasi dan dapat direproduksi secara deterministik:
1. Discovery & Scraping
Menyaring kompetisi yang telah rampung dengan minimal 50 tim peserta dan ukuran dataset maksimal 200 GB. Mengunduh data resmi, deskripsi problem, dan leaderboard privat tanpa kebocoran solusi forum publik.
2. Analyzer & Modality Extraction
Menganalisis tipe modalitas (tabular, citra computer vision, NLP, time-series, audio), memetakan nama kolom target, serta mendeteksi metrik evaluasi resmi (F1, AUC-ROC, RMSE, Normalized Gini).
3. Generator & Split Sanitization
Jika label private test tidak dirilis, sistem mengisolasi held-out split secara otomatis dari data berlabel asli, menjaga label tetap tersembunyi di sisi verifikator evaluasi independen.
4. Validator & Execution Repair
Mengeksekusi kode verifikasi pada real data untuk memastikan zero runtime crash, memeriksa integritas ID baris, dan memvalidasi skor metrik. 154 task lolos audit ketat dan siap digunakan untuk pelatihan RL.
3. Hierarchical Agentic SFT dengan Outcome-Guided Truncation
Pelatihan Supervised Fine-Tuning (SFT) untuk agen rekayasa jangka panjang menghadapi dilema: trajektori panjang sering kali memuat fase penemuan yang cemerlang, namun diikuti oleh fase regresi akibat over-tuning atau degradasi acak sebelum batas waktu berakhir. Jika seluruh riwayat dilatihkan secara naif, model akan meniru perilaku degradasi tersebut.
MLExpert menerapkan struktur Hierarchical Agentic SFT dua tahap yang dilengkapi mekanisme penyaringan berbasis luaran nyata (outcome-guided supervision selection):
- Tahap 1 — General Agent SFT: Menggunakan trajektori tool-use dan coding umum dari StepFun untuk menanamkan kemampuan dasar pemanggilan fungsi, parsing output bash, dan manipulasi sistem file dengan batas sequence 131.072 token.
- Tahap 2 — Domain-Specific MLE & Scientific SFT: Menggabungkan 636 trajektori pilihan (412 trajektori MLE dan 224 trajektori eksperimen sains berbasis 164 makalah Nature-family) dengan panjang konteks hingga 262.144 token.
- Eliminasi Tail Degradasi dengan Anchor Peak: Untuk trajektori yang melampaui ambang kualitas dasar $\eta = 0.4$, sistem mendeteksi kemunculan skor terbaik pertama $j^* = \min \{j \mid b_j = \max_k b_k\}$. Jika performa pasca-peak mengalami degradasi melebihi $\delta = 0.05$, trajektori langsung dipotong pada batas interaksi alat di dekat anchor tersebut. Ini menjamin data training hanya memuat eksplorasi produktif dan recovery dari error awal, tanpa mencemari model dengan over-optimasi destruktif.
- Masking Token Umpan Balik Lingkungan: Loss gradient hanya dihitung pada token penalaran (reasoning trace) dan pemanggilan tool baru yang dihasilkan model. Seluruh output eksekusi bash dan riwayat konteks terdahulu dimaskir ($M_{mjt} = 0$), mencegah model menghafal output runtime lokal.
4. Windowed Interaction Reinforcement Learning (WIRL)
Inovasi terpenting dari makalah ini terletak pada perumusan Windowed Interaction RL (WIRL). Pada algoritma RL standar untuk penalaran matematis seperti GRPO (Group Relative Policy Optimization), reward baru dapat dihitung setelah seluruh proses selesai, dan advantage dinormalisasi secara relatif antar generasi dalam grup yang sama.
Pada tugas MLE, satu trajektori dapat memakan waktu hingga 12 jam pada GPU NVIDIA H200. Menunggu seluruh trajektori selesai untuk menghitung update kebijakan akan menyebabkan learner idle starvation hingga 80% waktu komputasi! Lebih buruk lagi, satu error sintaksis sepele di jam ke-11 akan menghukum seluruh keputusan cerdas yang diambil model pada 10 jam sebelumnya.
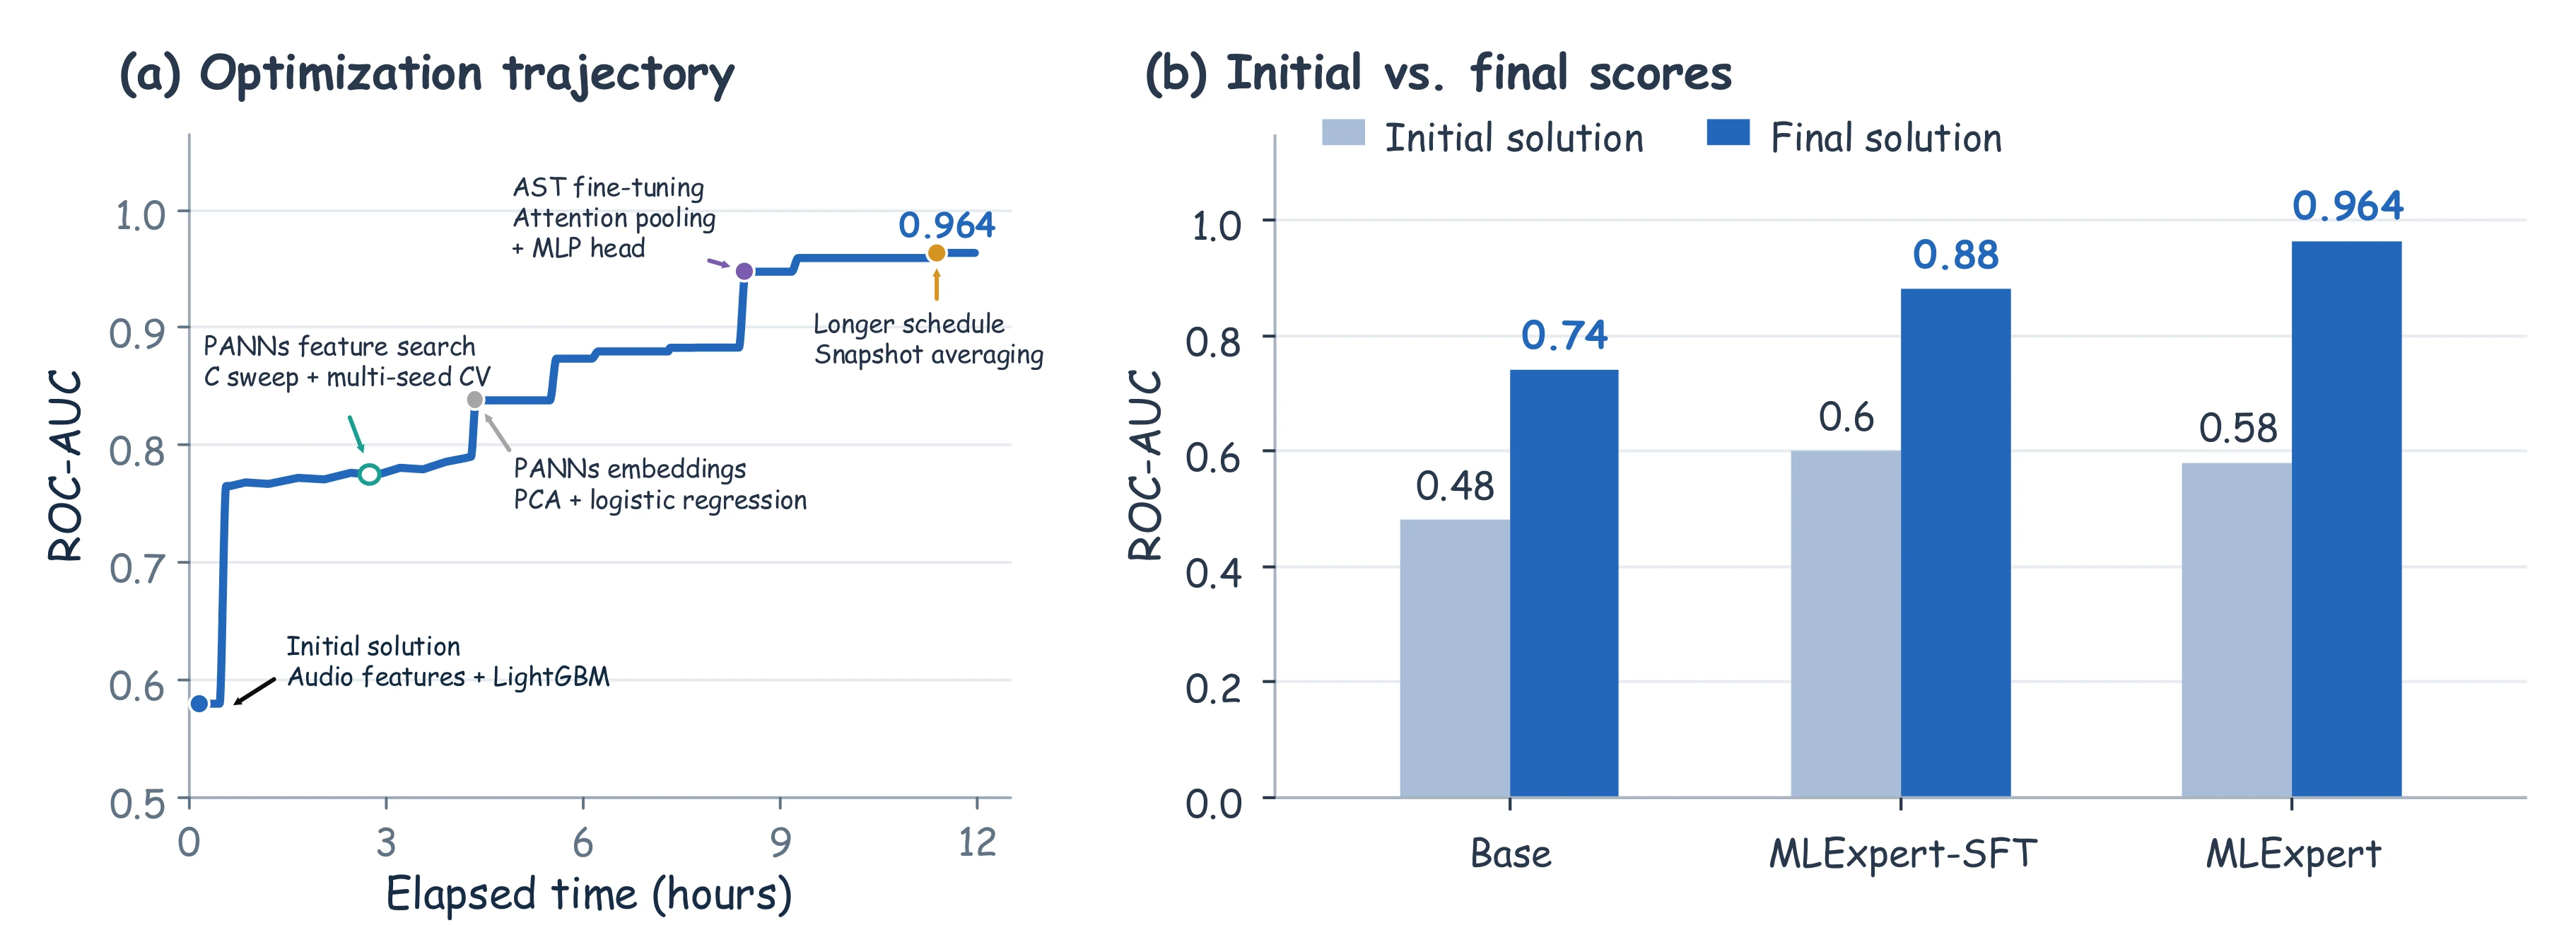
Gambar 3: Alur Windowed Interaction RL (WIRL) — Segmentasi multi-turn decisions ke dalam window $u_m$ antar pemanggilan execute_code, alokasi reward berbasis medali, dan koreksi kebijakan off-policy.
Formulasi Matematis Reward & Trend Lokal
WIRL mengelompokkan keputusan multi-turn model antara dua eksekusi eksperimen berurutan ke dalam sebuah execution window $u_m$. Setiap window dievaluasi langsung menggunakan reward verifikasi nyata $R_m$:
Di mana $T_m \in \{-0.2, 0, 0.2\}$ adalah local performance trend yang mencerminkan apakah submission saat ini mengalami penurunan, stagnan, atau peningkatan relatif terhadap submission valid sebelumnya. Dengan menetapkan $\widehat{A}_m = R_m$ secara langsung tanpa normalisasi grup yang bias, gradien kebijakan langsung diperkuat oleh feedback eksekusi riil.
Asynchronous Collection & Token-Level Policy Correction
Karena durasi training script sangat bervariasi (dari hitungan detik untuk regresi logistik hingga puluhan menit untuk deep ensemble), WIRL mengumpulkan execution window secara asinkron. Akibatnya, bobot model saat pengumpulan (rollout policy $\ell^{\text{roll}}$) dapat berbeda dengan bobot saat training batch dioptimalkan.
Untuk mencegah ledakan variansi tanpa membuang sampel berharga, WIRL menerapkan token-level policy correction dengan truncated importance sampling:
Dengan parameter $q_{\min} = 0.2$ dan $q_{\max} = 4.0$, token di luar rentang aman dikeluarkan dari perhitungan loss kebijakan, sementara token di dalam interval diskalakan secara proporsional.
5. Evaluasi Empiris & Perbandingan Benchmark MLE-Bench Lite
Evaluasi dilakukan pada MLE-Bench Lite—subset 22 kompetisi Kaggle standar industri yang mencakup klasifikasi tabular, segmentasi citra medis, hingga deteksi NLP. Setiap agen dialokasikan 3.000 langkah interaksi, batas waktu 12 jam, 20 vCPU, 220 GB RAM, dan satu GPU NVIDIA H200.
| Model | Total / Active Param | Gold (%) | Silver (%) | Bronze (%) | Any Medal (%) |
|---|---|---|---|---|---|
| Qwen3.6-35B-A3B (Base) | 35B / ~3B | 22.7% | 7.6% | 7.6% | 37.9% |
| Ornith-1.5-35B-A3B | 35B / ~3B | 22.7% | 12.1% | 4.5% | 39.4% |
| Nex-N2.5-mini | ~30B MoE | 24.2% | 13.6% | 9.1% | 47.0% |
| DeepSeek-V4-Pro Preview | Frontier Dense/MoE | 40.9% | 13.6% | 9.1% | 63.6% |
| GLM-5.3 | Frontier MoE | 59.1% | 13.6% | 0.0% | 72.7% |
| Kimi-K3 | Frontier Reasoning | 63.6% | 9.1% | 0.0% | 72.7% |
| MLExpert (Ours) | 35B / ~3B | 50.0% (+27.3%) | 16.7% | 6.1% | 72.7% (+34.8%) |
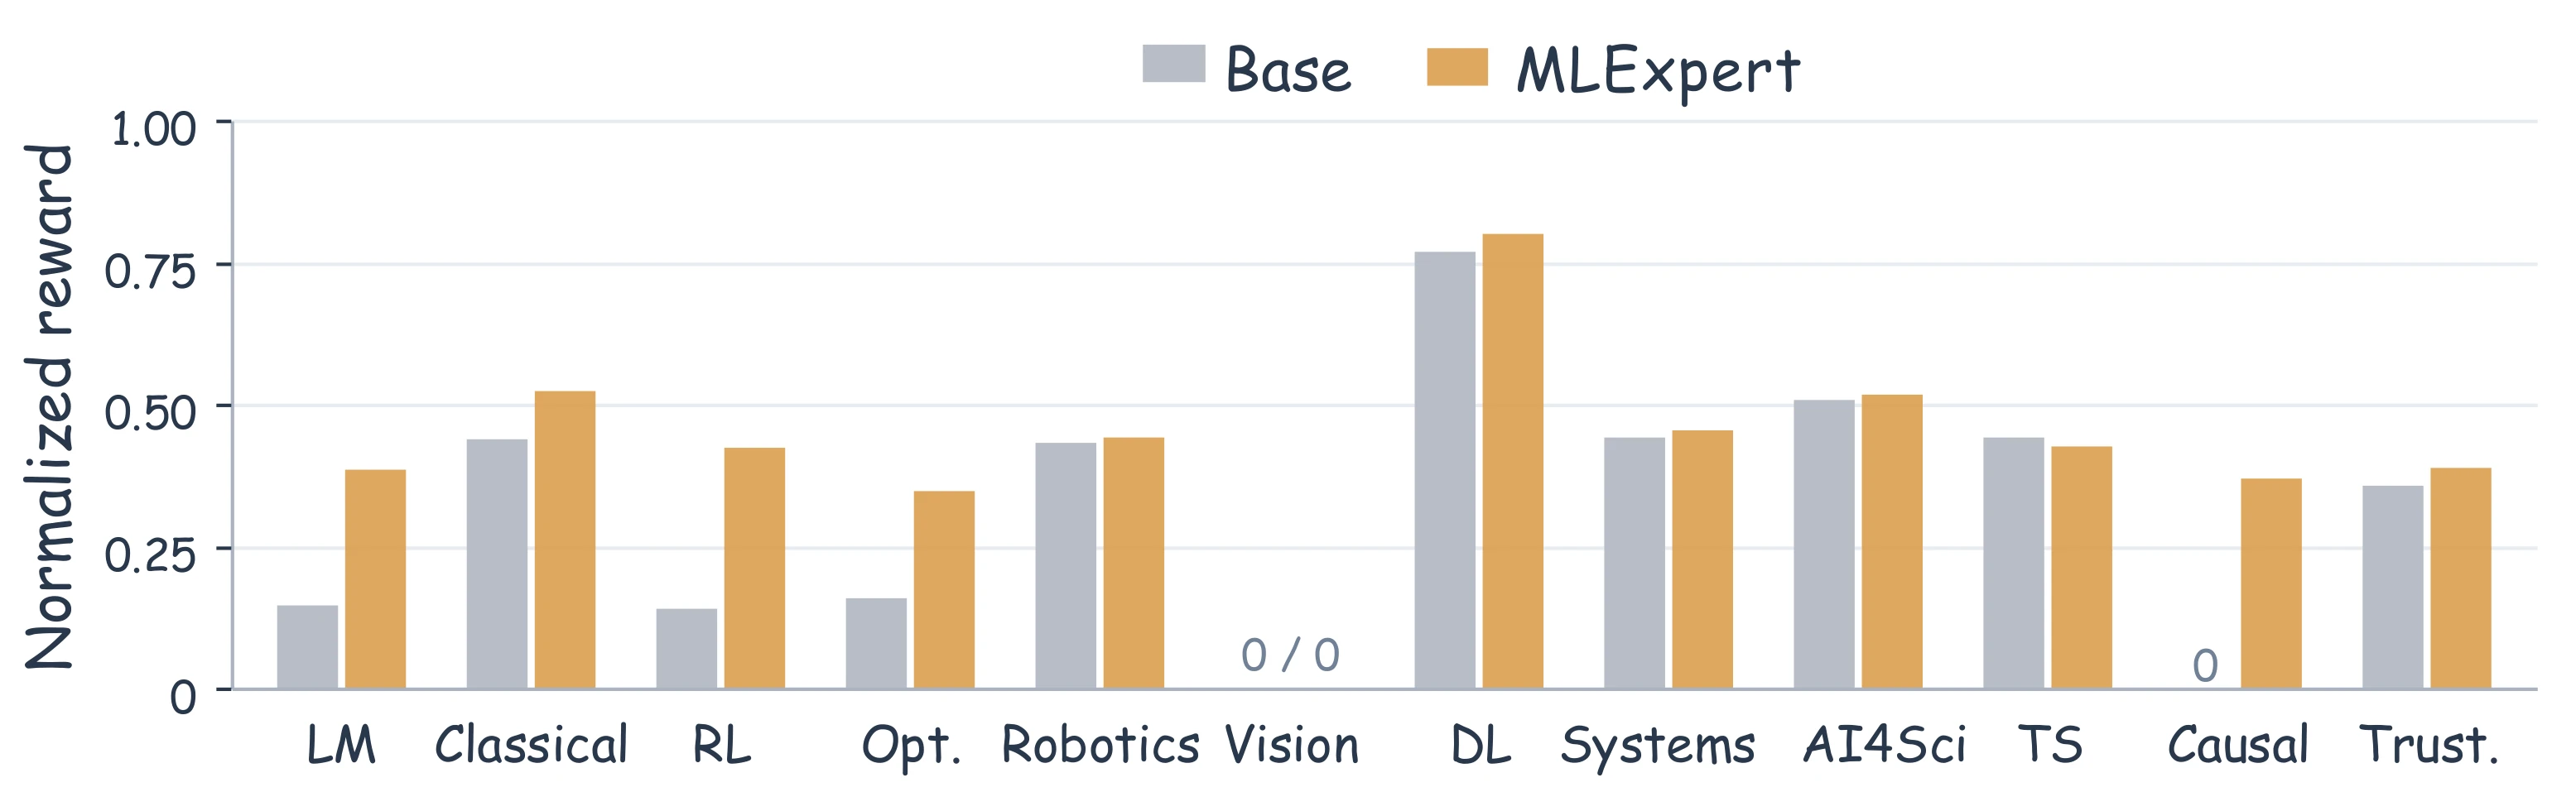
Gambar 4: Analisis Ablasi Komponen Pelatihan — Lonjakan perolehan medali pada setiap tahap post-training dari Base (37.9%) hingga WIRL penuh (72.7%).
Temuan Kunci dari Eksperimen:
- Efisiensi Ekstrem Model 35B: Dengan hanya mengaktifkan ~3B parameter per token selama inferensi, MLExpert menyamai performa keseluruhan Kimi-K3 dan GLM-5.3 (72.7% Any Medal) dan meraih tingkat medali emas 50.0%—membuktikan bahwa penguasaan domain MLE tidak mutlak memerlukan model raksasa jika diberikan supervisi trajektori yang tepat.
- Generalisasi Bebas ke Claude Code Harness: Saat diuji pada general-purpose coding harness (Claude Code CLI), MLExpert mempertahankan perolehan medali 69.7% (vs 42.4% untuk base model), mengungguli Nex-N2.5-mini sebesar 33.3 poin persentase. Ini menegaskan bahwa kemampuan yang dipelajari adalah intuisi rekayasa dan optimasi algoritma yang mandiri, bukan penghafalan pola tool tertentu.
- Transfer Pengetahuan Ilmiah di NatureBench Lite: Pada tolok ukur eksperimen sains (NatureBench), MLExpert mencapai 70% Match-SOTA dan 50% Surpass-SOTA ($g > 0.1$), melampaui MiniMax M3 (30%) dan GPT-5.5 (40%), membuktikan bahwa reasoning MLE mentransfer secara efektif ke penemuan sains otomatis.
6. Implementasi TypeScript Produksi: WIRL Execution Engine & Policy Correction
Di bawah ini adalah implementasi referensi produksi dari WIRL Engine dalam TypeScript, mencakup segmentasi execution window, perhitungan reward berbasis medali dan trend lokal, pemotongan tail degradasi untuk SFT, serta kalkulasi bobot koreksi kebijakan off-policy:
// Production Implementation: MLExpert Windowed Interaction RL (WIRL) Engine & Task Harness
// Berdasarkan formulasi formal arXiv:2610.22344 (Shanghai AI Lab & ECNU)
// Mengimplementasikan:
// 1. Multi-Turn Execution Window Segmentation (u_m antara execute_code calls)
// 2. Shared Verifiable Window Reward Calculation (Eq. 2: R_m = BaseReward + T_m)
// 3. Token-Level Off-Policy Importance Correction (Eq. 3: q_mjt in [q_min, q_max])
// 4. Outcome-Guided Supervision Truncation (Post-Peak Degradation Delta Guard)
// 5. Asynchronous Batch Collector & Normalized Window Loss Aggregator

export type MedalTier = 'none' | 'bronze' | 'silver' | 'gold';

export interface TaskEvaluationResult {
  executionError: boolean;
  isModelCausedError: boolean;
  hasValidSubmission: boolean;
  score: number;
  metricDirection: 'maximize' | 'minimize';
  medalTier: MedalTier;
  privateLeaderboardPercentile: number; // b_j in [0, 1]
}

export interface ModelCallRecord {
  callId: string;
  turnIndex: number;
  generatedTokens: string[];
  logProbCurrent: number[];  // \ell_{\theta,mjt}
  logProbRollout: number[];  // \ell^{roll}_{mjt}
  logProbOldPolicy: number[]; // \ell^{old}_{mjt}
  isMainModelOutput: boolean[]; // Token loss mask M_{mjt}
}

export interface ExecutionWindow {
  windowId: number; // m
  startStep: number;
  endStep: number;
  modelCalls: ModelCallRecord[];
  launchAction: 'execute_code' | 'update_answer' | 'terminal_exit';
  evalResult?: TaskEvaluationResult;
  computedReward?: number; // R_m
  sharedAdvantage?: number; // \widehat{A}_m
}

export class WIRLExecutionEngine {
  private readonly qMin: number;
  private readonly qMax: number;
  private readonly qualityThresholdEta: number;
  private readonly degradationThresholdDelta: number;
  private previousValidScore: number | null = null;

  constructor(
    qMin: number = 0.2,
    qMax: number = 4.0,
    qualityThresholdEta: number = 0.4,
    degradationThresholdDelta: number = 0.05
  ) {
    this.qMin = qMin;
    this.qMax = qMax;
    this.qualityThresholdEta = qualityThresholdEta;
    this.degradationThresholdDelta = degradationThresholdDelta;
  }

  /**
   * 1. Window Reward Computation (Eq. 2)
   * Menghitung R_m berdasarkan status verifikasi riil dan trend lokal T_m
   */
  public computeWindowReward(
    result: TaskEvaluationResult,
    isFirstValidSubmission: boolean
  ): { reward: number; localTrend: number } {
    // Kasus 1: Error fatal akibat tindakan model
    if (result.executionError && result.isModelCausedError) {
      return { reward: -1.0, localTrend: 0.0 };
    }

    // Kasus 2: Eksekusi selesai tanpa error tetapi tidak menghasilkan submission valid
    if (!result.hasValidSubmission) {
      return { reward: -0.6, localTrend: 0.0 };
    }

    // Hitung local performance trend T_m in {-0.2, 0, 0.2}
    let localTrend = 0.0;
    if (!isFirstValidSubmission && this.previousValidScore !== null) {
      const isBetter = result.metricDirection === 'maximize'
        ? result.score > this.previousValidScore
        : result.score < this.previousValidScore;
      const isWorse = result.metricDirection === 'maximize'
        ? result.score < this.previousValidScore
        : result.score > this.previousValidScore;

      if (isBetter) localTrend = 0.2;
      else if (isWorse) localTrend = -0.2;
      else localTrend = 0.0;
    }

    // Update historical score tracker
    this.previousValidScore = result.score;

    // Tentukan reward berdasarkan tier medali kompetisi
    if (result.medalTier === 'gold') {
      return { reward: 2.0 + localTrend, localTrend };
    }
    if (result.medalTier === 'silver' || result.medalTier === 'bronze') {
      return { reward: 1.0 + localTrend, localTrend };
    }

    // Submission valid tapi di bawah threshold medali
    return { reward: -0.4 + localTrend, localTrend };
  }

  /**
   * 2. Token-Level Policy Correction Factor (Eq. 3)
   * Mengoreksi pergeseran distribusi kebijakan rollout asinkron:
   * q = exp(ell^{old} - ell^{roll}), c = sg(q * 1[q_min <= q <= q_max])
   */
  public computeTokenCorrectionWeights(
    call: ModelCallRecord
  ): { weights: number[]; activeTokensCount: number } {
    const weights: number[] = [];
    let activeTokensCount = 0;

    for (let t = 0; t < call.generatedTokens.length; t++) {
      if (!call.isMainModelOutput[t]) {
        weights.push(0.0);
        continue;
      }

      const diff = call.logProbOldPolicy[t] - call.logProbRollout[t];
      const q = Math.exp(diff);

      // Truncated importance sampling guard
      if (q >= this.qMin && q <= this.qMax) {
        weights.push(q);
        activeTokensCount++;
      } else {
        // Excluded from policy-gradient update
        weights.push(0.0);
      }
    }

    return { weights, activeTokensCount };
  }

  /**
   * 3. Outcome-Guided Supervision Truncation (Section 4.1)
   * Memotong trajektori eksperimen jika terjadi regresi performa setelah peak
   */
  public filterTrajectoryForSFT(
    submissionPercentiles: number[] // b_1 ... b_K
  ): { passFilter: boolean; bestAnchorIndex: number; truncateAtLast: boolean } {
    if (submissionPercentiles.length === 0) {
      return { passFilter: false, bestAnchorIndex: -1, truncateAtLast: false };
    }

    const maxScore = Math.max(...submissionPercentiles);
    if (maxScore < this.qualityThresholdEta) {
      // Seluruh trajektori di bawah ambang kualitas dasar
      return { passFilter: false, bestAnchorIndex: -1, truncateAtLast: false };
    }

    const firstBestIndex = submissionPercentiles.indexOf(maxScore);
    const postBestScores = submissionPercentiles.slice(firstBestIndex + 1);

    // Periksa apakah terjadi degradasi performa melebihi ambang batas delta (0.05)
    let hasDegraded = false;
    for (const score of postBestScores) {
      if (maxScore - score > this.degradationThresholdDelta) {
        hasDegraded = true;
        break;
      }
    }

    if (hasDegraded) {
      // Jangkar ke first best submission untuk membuang tail yang memburuk
      return { passFilter: true, bestAnchorIndex: firstBestIndex, truncateAtLast: false };
    }

    // Jika tidak ada degradasi, pertahankan seluruh interaksi hingga submission terakhir
    return { passFilter: true, bestAnchorIndex: submissionPercentiles.length - 1, truncateAtLast: true };
  }
}
7. Rekomendasi Arsitektural untuk Tim AI Engineering & Platform Developer
Bagi organisasi teknologi dan praktisi yang sedang membangun sistem autonomous agent atau platform rekayasa berbasis AI, makalah MLExpert menyajikan prinsip-prinsip arsitektur krusial:
- Tinggalkan State Machine Kaku untuk Problem Kompleks: Jangan membatasi agen AI dalam alur linear statis (seperti EDA -> Feature -> Model -> Ensemble). Berikan antarmuka tools yang fleksibel dan izinkan model merancang sendiri hipotesis serta jalur eksekusinya berbasis execution logs.
- Gunakan Window-Based RL untuk Loop yang Memakan Waktu: Jika aplikasi agen Anda melibatkan eksekusi eksternal yang lambat (seperti kompilasi software besar, simulasi CFD, atau ML training), hindari episode-level reward. Segmentasikan interaksi ke dalam window yang diakhiri oleh pemanggilan tool eksekusi berat dan kaitkan reward langsung ke hasil lokal tersebut.
- Terapkan Outcome-Guided Data Filtering: Saat memanen trajektori dari model guru untuk SFT, jangan sertakan bagian akhir trajektori yang mengalami degradasi performa. Potong data pada anchor performa puncak pertama untuk memastikan agen Anda hanya mempelajari pola recovery dan keberhasilan.
- Waspadai Pergeseran Kebijakan Asinkron: Dalam arsitektur distributed agent rollouts, selalu catat log-probability dari model pembuat rollout. Terapkan importance sampling ratio yang dibatasi ($[q_{\min}, q_{\max}]$) agar batch gradient update tetap stabil dan tidak mengalami keruntuhan konvergensi.
Referensi & Sumber Terverifikasi
- [1]MLExpert: Towards a Generalist Agentic Model for Autonomous Machine Learning Engineering(arXiv:2610.22344 [cs.AI, cs.CL, cs.LG] — Shangheng Du, Jinxin Shi, Shuaiyu Zhang, Yiming Wu, Junpeng Zhao, Shiyang Feng, Xin Li, Liang He, Xiangchao Yan, Bo Zhang (East China Normal University & Shanghai Artificial Intelligence Laboratory))
- [2]MLExpert Open-Source Research Codebase & Task Packages(InternScience / GitHub Research Repository)
- [3]MLExpert 35B Mixture-of-Experts Model Weights & Checkpoints(Hugging Face Hub / InternScience)
- [4]MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering(arXiv:2410.07095 — Jun Shern Chan et al. (OpenAI))
- [5]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Baseline)(arXiv:2402.03300 — Zhihong Shao et al. (DeepSeek AI))
- [6]NatureBench: Evaluating Autonomous Scientific Research Agents on Nature Papers(arXiv:2603.01892 — Wang et al. (Peking University & Shanghai AI Lab))
- [7]ReAct: Synergizing Reasoning and Acting in Language Models(ICLR 2023 — Shunyu Yao et al. (Princeton University & Google Brain))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.

Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.

DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.