KnowGPO (arXiv:2610.22331): Knowledge-Grouped Policy Optimization, Dekomposisi Kondisi Atomik, dan Eliminasi Noise Observasi pada Deep Search Agents
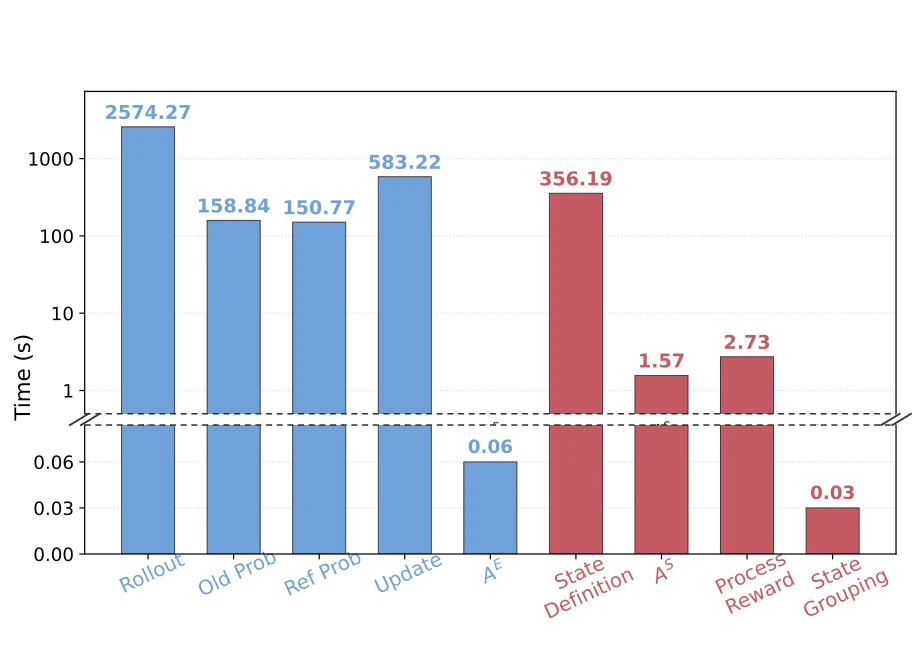
Bedah arsitektur riset frontier arXiv:2610.22331 (Siqi Chen et al. — Zhejiang University & Tencent, EMNLP 2026): Mengapa Group Relative Policy Optimization (GRPO) dan process supervision berbasis observasi permukaan (GiGPO) kerap gagal pada deep search agents? KnowGPO mendekomposisi kueri menjadi kondisi pengetahuan atomik k_j dan memetakan trajektori ke dalam ruang vektor biner monotonik s_{i,t} in {0, 1}^K. Dengan mengelompokkan langkah trajektori yang berangkat dari posisi pengetahuan identik (G(s)), perolehan pengetahuan inkremental (||s_{i,t}||_1 - ||s_{i,t-1}||_1) menjadi process reward alami tanpa ketergantungan pada model critic yang bias. Menggunakan backbone Qwen3-8B, KnowGPO meraih 48.0% pada Xbench-2505, 38.8% pada BrowseComp-ZH, dan 40.2% pada GAIA—menyamai performa model open-source 32B dengan 97.8% effective step alignment dan overhead komputasi di bawah 3%.
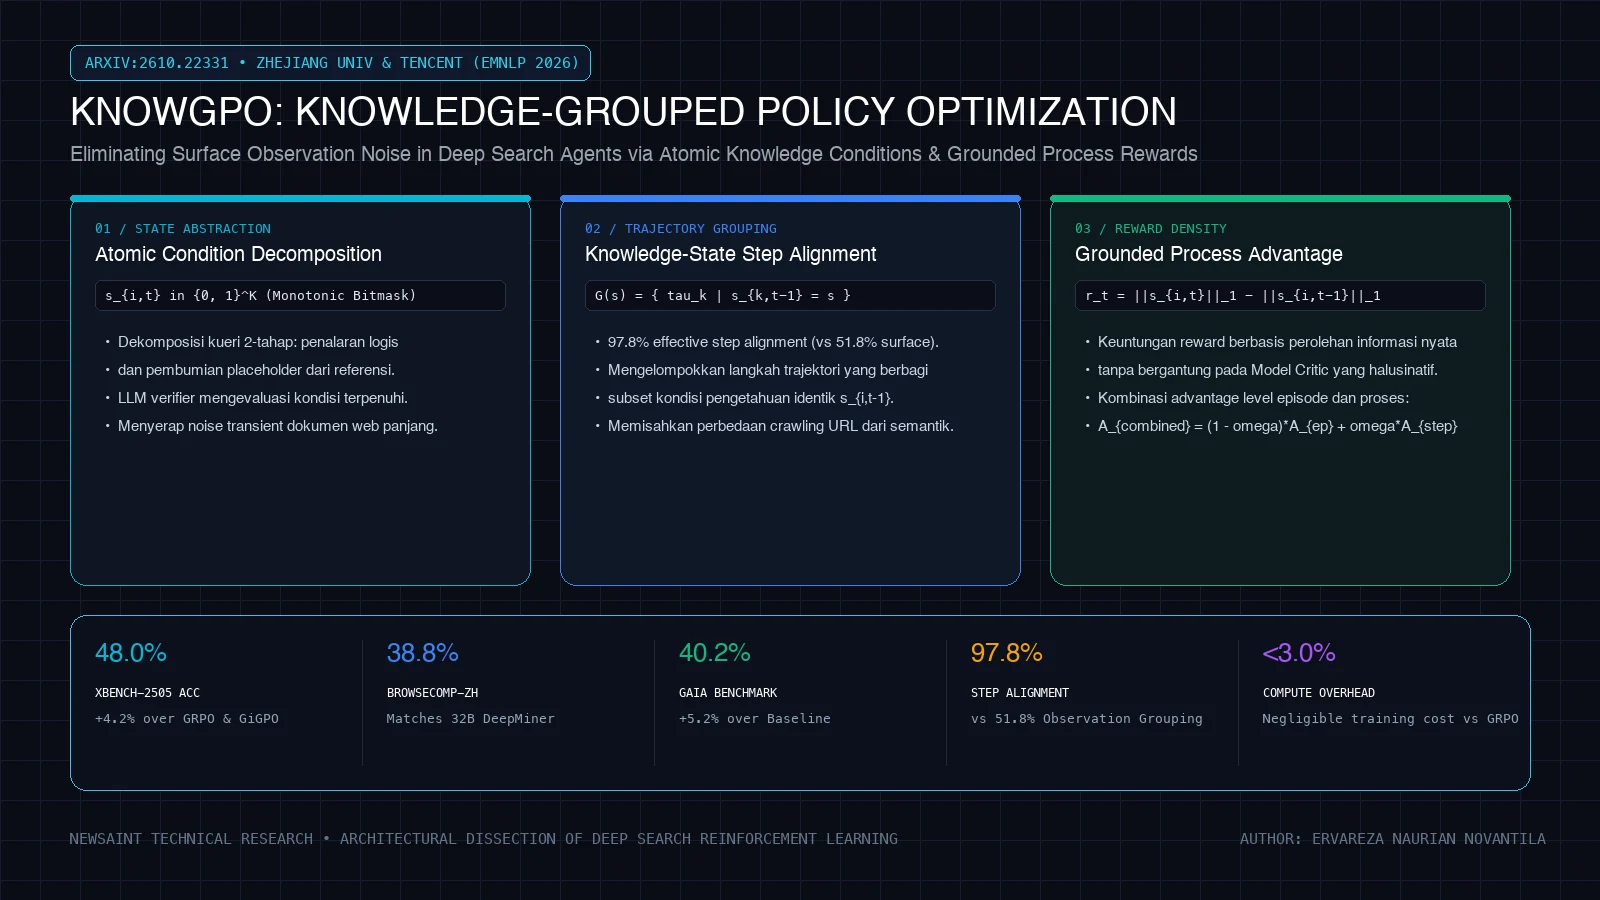
Evolusi model penalaran dari sekadar Retrieval-Augmented Generation (RAG) statis menuju Deep Search Autonomous Agents membuka babak baru dalam pemecahan masalah kompleks: model kini mampu merumuskan kueri penelusuran secara adaptif, mengecek dokumen web puluhan ribu token, memeriksa silang bukti, dan memutuskan secara mandiri kapan harus berhenti. Namun, melatih agen pencari mendalam ini dengan Reinforcement Learning konvensional seperti GRPO (Group Relative Policy Optimization) menghadapi krisis alokasi kredit fundamental (credit assignment bottleneck). Makalah riset terbaru dari Zhejiang University dan Tencent (Chen et al., EMNLP 2026) memperkenalkan KnowGPO (Knowledge-Grouped Policy Optimization)—metodologi yang membongkar keterbatasan evaluasi hasil akhir (outcome-only) dan membuktikan bahwa atribusi kredit langkah harus dijangkarkan pada kondisi pengetahuan semantik atomik, bukan pada observasi permukaan teks yang rentan bising.
1. Anatomi Kegagalan GRPO & Process Supervision Konvensional pada Deep Search
Dalam skenario pencarian mendalam berhorizon panjang (long-horizon multi-turn search), sebuah agen AI dapat mengambil antara 10 hingga 30 langkah interaksi sebelum mengeluarkan jawaban final. Interaksi ini melibatkan pemanggilan search engine API, penjelajahan halaman dokumen HTML yang panjang dan berantakan, ekstraksi kutipan, hingga sintesis penalaran. Pendekatan pelatihan RL dominan saat ini menemui jalan buntu pada dua kubu:
- Outcome-Only RL (GRPO / RLVR): Algoritma seperti GRPO (yang dipopulerkan oleh DeepSeekMath dan DeepSeek-R1) hanya memberikan sinyal biner tunggal di ujung trajektori: $R(\tau) \in \{0, 1\}$. Kelemahan fatalnya adalah credit dilution: jika agen melakukan 15 langkah penelusuran brilian namun salah mengetik format di langkah ke-16, seluruh langkah brilian tersebut dihukum dengan penalti yang sama. Sebaliknya, jika agen melakukan penelusuran acak yang beruntung menemukan jawaban karena redundansi web, langkah-langkah sia-sia tersebut justru diperkuat.
- Surface Observation Grouping (GiGPO): Upaya memberikan pengawasan tingkat langkah (step-level supervision) sebelumnya mencoba mengelompokkan trajektori yang mengunjungi "state lingkungan yang sama" menggunakan kesamaan representasi embedding teks (misal cosine similarity BGE-large > 0.9). Pada deep search, metode ini runtuh total: dokumen web bersifat terbuka dan heterogen. Dari evaluasi empiris pada 5.922 trajektori nyata, pengelompokan observasi menghasilkan 79.4% singleton groups (hanya 51.8% langkah yang berhasil disejajarkan). Akibatnya, perbandingan keuntungan di dalam grup terdegenerasi menjadi perbandingan satu langkah dengan dirinya sendiri ($A = 0$).
- Internal Confidence Anchoring (IGPO): Pendekatan lain mencoba menghitung reward langkah dari lonjakan probabilitas internal model terhadap jawaban benar. Namun, sinyal keyakinan internal ini sangat rapuh terhadap bias konteks dokumen web yang panjang dan bising, kerap memicu halusinasi kepastian semu sebelum bukti yang cukup ditemukan.
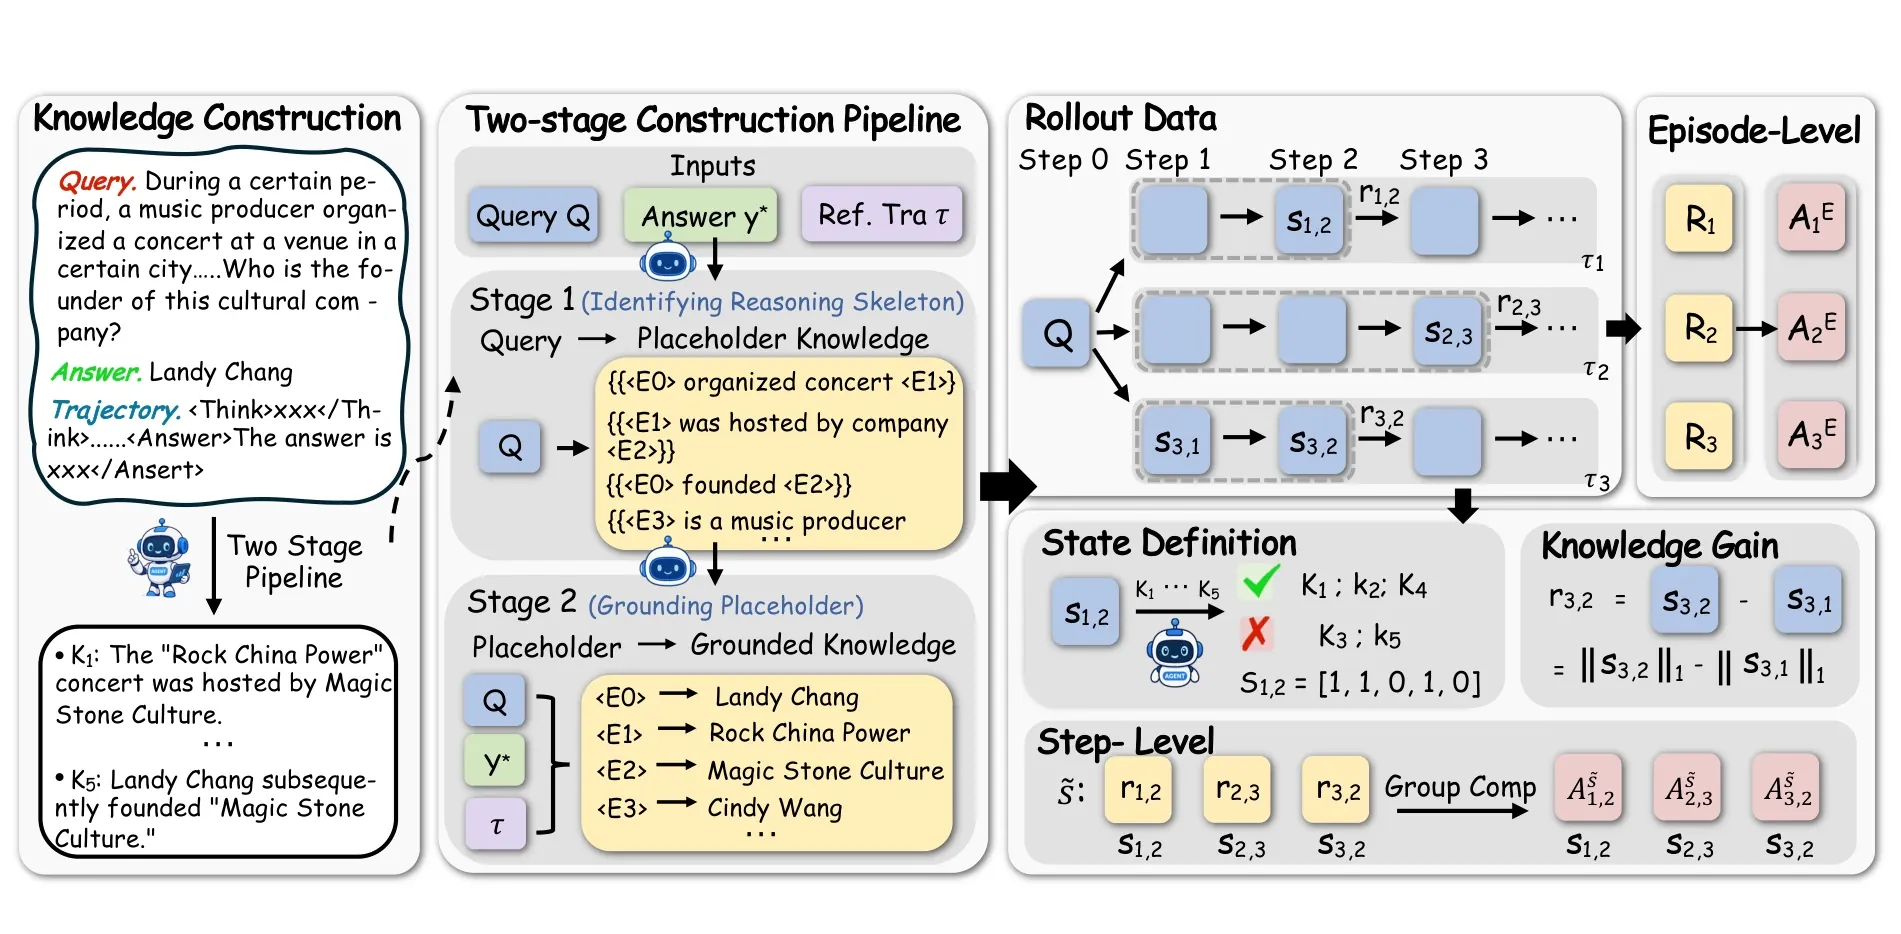
2. Abstraksi Status Pengetahuan: Dekomposisi Dua Tahap & Bitmask Monotonik
Terobosan kunci KnowGPO adalah mengabstraksikan progres pencarian bukan dari representasi teks observasi permukaan yang berfluktuasi, melainkan dari himpunan kondisi pengetahuan relevan yang berhasil diverifikasi.
A. Pipeline Dekomposisi Dua Tahap (Two-Stage Construction)
Untuk setiap kueri $Q$ dengan jawaban referensi $y^*$, KnowGPO membentuk himpunan kondisi pengetahuan atomik terhingga:
di mana masing-masing $k_j$ merepresentasikan kendala faktual tunggal (single-hop fact) yang mutlak diperlukan untuk menarik kesimpulan logis ke $y^*$. Konstruksi ini dijalankan melalui dua tahap:
- Stage 1 — Ekstraksi Skeleton Penalaran: Mengidentifikasi rantai logika implisit dari kueri $Q$ dengan menyematkan placeholder untuk entitas yang belum diketahui, misalnya:
{<E0> menyelenggarakan konser <E1>},{<E1> diproduksi oleh perusahaan <E2>},{<E0> adalah pendiri <E2>}. - Stage 2 — Pembumian Placeholder (Grounding): Membumikan entitas placeholder menggunakan jawaban ground truth $y^*$ dan trajektori referensi yang sukses, mengikat
<E0>ke "Landy Chang",<E1>ke "Rock China Power", dan<E2>ke "Magic Stone Culture".
B. Akumulasi State Monotonik Terhadap Noise Verifier
Pada setiap langkah $t$ dari trajektori $\tau_i$, model verifier berbasis LLM (menggunakan DeepSeek-v3.2) memeriksa apakah observasi baru $o_{i,t}$ memenuhi satu atau beberapa kondisi $k_j$, menghasilkan vektor inkremen biner $\Delta s_{i,t} \in \{0, 1\}^K$:
Status pengetahuan kumulatif kemudian diakumulasikan secara monotonik melalui operasi bitwise OR:
Sifat monotonik ini krusial: fakta yang telah diperoleh agen di langkah sebelumnya tidak boleh hilang hanya karena halaman web di langkah berikutnya tidak lagi menampilkannya. Hal ini secara efektif menyerap transient noise dari verifier dan menjamin stabilitas semantik sepanjang puluhan langkah pencarian.
3. Mekanisme Pelatihan: Knowledge-Grouped Credit Assignment & Formulasi Keuntungan
Setelah ruang status didefinisikan secara semantik, KnowGPO membagi penghitungan keuntungan (advantage) ke dalam dua tingkat yang saling melengkapi:
A. Keuntungan Tingkat Episode (Global Task Alignment)
Dari $N$ trajektori yang di-sample untuk kueri yang sama, keuntungan tingkat episode dihitung persis seperti formulasi GRPO standar:
Komponen ini memastikan optimasi tetap terarah ke tujuan akhir dan mencegah agen terjebak dalam perilaku mengumpulkan informasi lokal (over-collecting loop) tanpa pernah menyelesaikan jawaban.
B. Keuntungan Tingkat Langkah Berbasis Partisi Pengetahuan (Local Epistemic Advantage)
Langkah-langkah non-terminal dari seluruh $N$ trajektori dipartisi ke dalam kelompok pengetahuan $G(\tilde{s})$. Dua langkah hanya dimasukkan ke dalam grup yang sama jika dan hanya jika keduanya memulai aksi dari status pengetahuan yang persis identik:
Reward proses didefinisikan sebagai perolehan pengetahuan inkremental (incremental knowledge gain):
Keuntungan tingkat langkah $A_{i,t}^S$ kemudian dinormalisasi di dalam kelompok $\mathcal{G}(\tilde{s})$:
Konstruksi ini menghasilkan perbandingan yang adil: langkah yang diambil agen dinilai relatif terhadap alternatif aksi yang dapat diambil dari posisi epistemik yang sama, bukan dibandingkan dengan langkah di fase pencarian lain yang berbeda konteks pengetahuannya.
C. Penggabungan Dual-Objective & Optimasi PPO Terpotong
Kedua sinyal keuntungan digabungkan dengan koefisien pencampuran $\omega = 0.3$:
Kebijakan $\pi_\theta$ kemudian dioptimalkan menggunakan fungsi objektif clipped surrogate PPO dengan penalti divergensi KL terhadap model referensi $\pi_{\text{ref}}$:
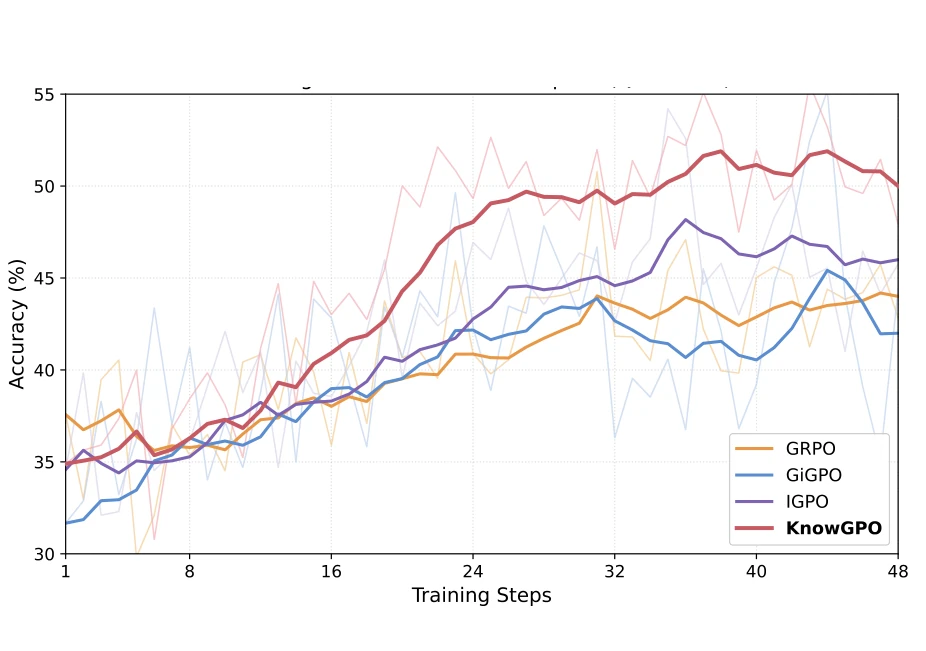
4. Pembuktian Empiris: Menyamai Model 32B pada Skala 8B
Peneliti mengevaluasi KnowGPO pada tiga benchmark pencarian mendalam paling berat di industri: BrowseComp-ZH, GAIA (General AI Assistants), dan Xbench-2505 / Xbench-2510. Seluruh model open-source yang dilatih menggunakan basis bobot identik (Qwen3-8B dengan ekspansi konteks YaRN 128K tokens).
| Model & Konfigurasi | Parameter | BrowseComp-ZH | GAIA (Text) | Xbench-2505 |
|---|---|---|---|---|
| Advanced Agents (Proprietary Data / Closed Models) | ||||
| DeepSeek-V3.2 | 671B MoE | 49.2% | 63.1% | 78.0% |
| Claude-4-Sonnet | Closed | 29.1% | 68.3% | 64.6% |
| Leading Open-Source Systems | ||||
| WebSailor-32B | 32B Dense | 25.5% | 51.5% | – |
| DeepMiner-32B-RL | 32B Dense | 40.1% | 58.7% | – |
| MiroThinker-v1.0 | 8B Dense | – | – | 60.6% |
| Controlled RL Training (Identical Qwen3-8B Backbone) | ||||
| Qwen3-8B-SFT | 8B Dense | 30.1% | 31.1% | 39.0% |
| + GRPO (Outcome-only) | 8B Dense | 32.9% | 35.0% | 46.0% |
| + GiGPO (Observation Grouping) | 8B Dense | 37.3% | 35.0% | 44.0% |
| + IGPO (Internal Confidence) | 8B Dense | 32.2% | 37.9% | 46.0% |
| + KnowGPO (Full) | 8B Dense | 38.8% (+5.9%) | 40.2% (+5.2%) | 48.0% (+2.0%) |
5. Analisis Mekanistik: Mengapa Status Pengetahuan Jauh Lebih Unggul dari Observasi?
Eksperimen diagnostik pada 5.922 trajektori (55.571 total langkah penelusuran) membedah penyebab empiris di balik dominasi KnowGPO atas metode pengelompokan lainnya:
| Anchor Pengelompokan | Effective Step Ratio (ESR) | Singleton Ratio | Mean Group Size | Cross-Rollout Coverage |
|---|---|---|---|---|
| Surface Observation (GiGPO) | 51.8% | 79.4% | 1.82 | 1.41 rollouts |
| Action Similarity (Generated Query) | 64.3% | 68.1% | 2.14 | 1.69 rollouts |
| Knowledge State (KnowGPO - Ours) | 97.8% (+46.0%) | 12.1% (-67.3%) | 4.76 | 3.88 rollouts |
Data di atas menunjukkan fakta fundamental dalam rekayasa agen:
- Eliminasi Fenomena Singleton: Dengan knowledge state, 97.8% langkah berada di dalam grup non-singleton dengan rata-rata 3.88 trajektori berbeda per grup. Artinya, keuntungan dihitung dari perbandingan multi-agen yang kaya, bukan perbandingan kosong.
- Ablasi Reward Formula: Mengganti incremental gain $r_t$ dengan discounted future return $G_t$ ala GiGPO menurunkan akurasi hingga 6.0% di BrowseComp-ZH. Mengapa? Karena $G_t$ mengikat kredit langkah saat ini ke seluruh variansi acak di masa depan, sementara incremental gain memberikan sinyal lokal instan yang terbumikan ke fakta nyata.
- Nilai Optimal Omega: Pengujian parameter membuktikan $\omega = 0.3$ memberikan keseimbangan optimal. Memberikan bobot berlebih pada proses ($\omega = 0.5$) justru merusak konvergensi karena agen menjadi terlalu terobsesi mengumpulkan potongan informasi parsial dan melupakan batas waktu inferensi.
6. Implementasi TypeScript Produksi: Engine Partisi State & Perhitungan Advantage
Berikut adalah implementasi clean-architecture dari KnowGPO Engine dalam TypeScript yang dapat langsung disematkan pada runtime orkestrasi pencarian agen cerdas:
// Production Implementation: KnowGPO Knowledge State Engine & Grouped Advantage Calculator
// Berdasarkan formulasi formal arXiv:2610.22331 (Zhejiang University & Tencent, EMNLP 2026)
// Mengimplementasikan:
// 1. Two-Stage Atomic Knowledge Decomposition Tracker
// 2. Monotonic Binary Knowledge State Accumulator: s_{i,t} = s_{i,t-1} OR Delta s_{i,t}
// 3. Knowledge-Group Partitioning: G(s) = {(i, t) | s_{i,t-1} = s, a_{i,t} != answer}
// 4. Grounded Step-Level Reward & Group-Relative Advantage Normalization
// 5. Dual-Objective Advantage Blending: A_{i,t} = (1 - omega) * A_i^E + omega * A_{i,t}^S

export interface AtomicKnowledgeCondition {
  id: string; // k_j
  description: string;
  stage1Skeleton: string;
  groundedEntities: Record<string, string>; // { "<E0>": "Landy Chang", "<E1>": "Magic Stone" }
}

export interface StepObservation {
  turnIndex: number;
  action: 'search' | 'browse' | 'click' | 'answer';
  actionQuery?: string;
  rawObservation: string;
}

export interface TrajectoryStepRecord {
  episodeId: string;
  stepIndex: number;
  action: 'search' | 'browse' | 'click' | 'answer';
  observation: string;
  priorKnowledgeState: boolean[]; // s_{i,t-1}
  newKnowledgeDelta: boolean[];    // Delta s_{i,t}
  cumulativeKnowledgeState: boolean[]; // s_{i,t}
  incrementalGain: number;       // ||s_{i,t}||_1 - ||s_{i,t-1}||_1
  stepAdvantage?: number;        // A_{i,t}^S
  finalAdvantage?: number;       // A_{i,t}
}

export class KnowGPOEngine {
  private conditions: AtomicKnowledgeCondition[] = [];
  private readonly omega: number; // Mixing coefficient (default 0.3)
  private readonly epsilon: number = 1e-6;

  constructor(conditions: AtomicKnowledgeCondition[], omega: number = 0.3) {
    this.conditions = conditions;
    this.omega = omega;
  }

  /**
   * 1. Monotonic Knowledge State Accumulation (Eq. 2 & Eq. 3)
   * Menyerap noise transien verifier dan memastikan pengetahuan tidak terhapus
   */
  public updateKnowledgeState(
    priorState: boolean[],
    newDelta: boolean[]
  ): { nextState: boolean[]; gain: number } {
    const K = this.conditions.length;
    const nextState = new Array(K).fill(false);
    let priorCount = 0;
    let nextCount = 0;

    for (let j = 0; j < K; j++) {
      if (priorState[j]) priorCount++;
      // Monotonic OR operator: s_{i,t} = s_{i,t-1} lor Delta s_{i,t}
      nextState[j] = priorState[j] || (newDelta[j] ?? false);
      if (nextState[j]) nextCount++;
    }

    const gain = nextCount - priorCount; // r_{i,t} = ||s_{i,t}||_1 - ||s_{i,t-1}||_1
    return { nextState, gain };
  }

  /**
   * Mengubah vektor boolean ke representasi state hashable untuk grouping
   */
  public getStateKey(state: boolean[]): string {
    return state.map(b => (b ? '1' : '0')).join('');
  }

  /**
   * 2. Knowledge-Grouped Credit Assignment (Eq. 4 s.d. Eq. 8)
   * Mengelompokkan langkah berdasarkan state awal yang sama dan menghitung advantage
   */
  public computeGroupedAdvantages(
    episodes: {
      episodeId: string;
      steps: {
        action: 'search' | 'browse' | 'click' | 'answer';
        observation: string;
        deltaVerified: boolean[];
      }[];
      isSuccess: boolean;
    }[]
  ): TrajectoryStepRecord[] {
    const N = episodes.length;
    const K = this.conditions.length;

    // A. Hitung Episode-Level Advantage A_i^E (GRPO Outcome Normalization)
    const outcomeRewards = episodes.map(ep => (ep.isSuccess ? 1.0 : 0.0));
    const meanOutcome = outcomeRewards.reduce((a, b) => a + b, 0) / N;
    const varOutcome = outcomeRewards.reduce((a, b) => a + Math.pow(b - meanOutcome, 2), 0) / N;
    const stdOutcome = Math.sqrt(varOutcome);

    const episodeAdvantages = outcomeRewards.map(r => (r - meanOutcome) / (stdOutcome + this.epsilon));

    // B. Rollout lintasan dan ekstrak monotonic state per step
    const allStepRecords: TrajectoryStepRecord[] = [];
    // Map untuk mengelompokkan langkah: stateKey -> Array of reference records
    const knowledgeGroups = new Map<string, TrajectoryStepRecord[]>();

    episodes.forEach((ep, epIdx) => {
      let currentState = new Array(K).fill(false);

      ep.steps.forEach((step, stepIdx) => {
        const priorState = [...currentState];
        const { nextState, gain } = this.updateKnowledgeState(priorState, step.deltaVerified);
        currentState = nextState;

        const record: TrajectoryStepRecord = {
          episodeId: ep.episodeId,
          stepIndex: stepIdx,
          action: step.action,
          observation: step.observation,
          priorKnowledgeState: priorState,
          newKnowledgeDelta: step.deltaVerified,
          cumulativeKnowledgeState: currentState,
          incrementalGain: gain,
        };

        allStepRecords.push(record);

        // Abaikan langkah terminal 'answer' dari process grouping (Eq. 5)
        if (step.action !== 'answer') {
          const groupKey = this.getStateKey(priorState);
          if (!knowledgeGroups.has(groupKey)) {
            knowledgeGroups.set(groupKey, []);
          }
          knowledgeGroups.get(groupKey)!.push(record);
        }
      });
    });

    // C. Normalisasi Step-Level Advantage A_{i,t}^S di dalam masing-masing grup G(s)
    knowledgeGroups.forEach((groupSteps, stateKey) => {
      const gains = groupSteps.map(s => s.incrementalGain);
      const groupMean = gains.reduce((a, b) => a + b, 0) / groupSteps.length;
      const groupVar = gains.reduce((a, b) => a + Math.pow(b - groupMean, 2), 0) / groupSteps.length;
      const groupStd = Math.sqrt(groupVar);

      groupSteps.forEach(stepRec => {
        // Jika ukuran grup 1 (singleton) atau std == 0, advantage = 0
        if (groupSteps.length <= 1 || groupStd < 1e-7) {
          stepRec.stepAdvantage = 0.0;
        } else {
          stepRec.stepAdvantage = (stepRec.incrementalGain - groupMean) / (groupStd + this.epsilon);
        }
      });
    });

    // D. Gabungkan Episode-Level dan Step-Level Advantage (Eq. 8)
    const epAdvMap = new Map<string, number>();
    episodes.forEach((ep, idx) => {
      epAdvMap.set(ep.episodeId, episodeAdvantages[idx]);
    });

    allStepRecords.forEach(stepRec => {
      const epAdv = epAdvMap.get(stepRec.episodeId) ?? 0.0;
      const stepAdv = stepRec.stepAdvantage ?? 0.0;

      // Pada langkah terminal 'answer', gunakan 100% episode advantage
      if (stepRec.action === 'answer') {
        stepRec.finalAdvantage = epAdv;
      } else {
        stepRec.finalAdvantage = (1.0 - this.omega) * epAdv + this.omega * stepAdv;
      }
    });

    return allStepRecords;
  }
}
7. Rekomendasi Praktis untuk Insinyur AI & Pengembang Sistem Autonomous Search
Penelitian ini menyuguhkan prinsip arsitektur mutlak yang wajib diadopsi dalam merancang platform Deep Research dan AI Agents generasi berikutnya:
- Tinggalkan Pengelompokan Berbasis Teks Permukaan: Jangan pernah mencoba menyelaraskan trajektori penelusuran agen menggunakan embedding dokumen atau URL. Variasi crawling web terlalu dinamis. Petakan selalu dokumen ke dalam bitmask kondisi informasi yang telah terverifikasi.
- Terapkan Akumulasi Status Monotonik: Gunakan operasi bitwise OR ($s_t = s_{t-1} \lor \Delta s_t$) untuk melacak pemenuhan kondisi. Ini adalah peredam noise terbaik untuk mengatasi fluktuasi output model verifier atau ketidakkonsistenan ekstraksi teks.
- Gunakan Dual-Objective Blending (70/30): Pertahankan 70% bobot untuk outcome-level advantage ($1 - \omega = 0.7$) dan 30% untuk step-level knowledge gain ($\omega = 0.3$). Kombinasi ini memberikan densitas supervisi optimal tanpa kehilangan visi penyelesaian akhir tugas.
- Hemat Biaya Komputasi dengan Single-Stage RL: Dengan overhead komputasi kurang dari 3% di atas GRPO standar, KnowGPO membuktikan bahwa model 8B dapat menandingi model 32B open-source tanpa memerlukan dataset kepemilikan berbayar atau infrastruktur server reward model yang rumit.
Referensi & Sumber Terverifikasi
- [1]KnowGPO: Knowledge-Grouped Policy Optimization for Search Agents(arXiv:2610.22331 [cs.AI] — Siqi Chen, Zhengxi Lu, Yuchen Yan, Xingyu Wu, Qipeng Chen, Xin Zhang, Aiting Liu, Chao Deng, Jie Liu, Jin Ma, Weiming Lu, Jun Xiao, Yongliang Shen (Zhejiang University & Tencent, EMNLP 2026))
- [2]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Formulation)(arXiv:2402.03300 — Zhihong Shao et al. (DeepSeek AI))
- [3]GiGPO: Group-in-Group Policy Optimization for Long-Horizon Reasoning(arXiv:2505.11294 — Feng et al. (Tsinghua University & Microsoft Research))
- [4]IGPO: Internal-Grounded Process Optimization for Language Agent Policies(arXiv:2601.08452 — Wang et al. (Peking University))
- [5]BrowseComp: A Benchmark for Long-Horizon Multihop Web Browsing and Information Synthesis(arXiv:2502.04351 — Jason Wei et al. (OpenAI & Stanford University))
- [6]GAIA: A Benchmark for General AI Assistants(ICLR 2024 / arXiv:2311.12983 — Gregoire Mialon et al. (Meta AI, Hugging Face, AutoGPT))
- [7]Xbench: Deep Search and Complex Multimodal Information Retrieval Benchmark(Xbench Team & Tsinghua AIR)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.

Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.

DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.