KaliBench 2026: Arsitektur Benchmark Cybersecurity CLI pada 1.642 Tools Kali Linux, Runtime-Free Verifiable Rewards, dan Peningkatan Model 8B Setara 685B MoE
Analisis arsitektur sistemik riset frontier AI security dari RISys Lab MBZUAI (NeurIPS 2026 / arXiv:2610.02206, Pengfei Li, Naufal Suryanto, Sicheng Zhang, Muzammal Naseer, Oktober 2026): Mengapa evaluasi LLM pada operasi siber berbasis pengetahuan konseptual atau capture-the-flag (CTF) gagal mengukur presisi command-line interface (CLI) dunia nyata di mana satu kesalahan flag atau binding argumen membatalkan eksekusi. Memperkenalkan KaliBench, tolak ukur fine-grained natural-language-to-CLI translation mencakup 8.504 pasangan kueri-perintah terverifikasi, 1.642 tools pada 23 dimensi kapabilitas dan 5 fase keamanan siber. Menghadirkan inovasi Runtime-Free Verifiable Rewards untuk pelatihan RLVR/GRPO deterministik tanpa overhead sandbox container yang mahal dan berbahaya. Melalui supervised fine-tuning (SFT) dan GRPO berbasis reward deterministik, model 8B RedSage-K melonjak dari 19.7% ke 32.2% exact match pada pengujian unrestricted, menyaingi DeepSeek-V3.2 (685B MoE) dan melampaui seluruh model frontier open-weight 70B+ lainnya.
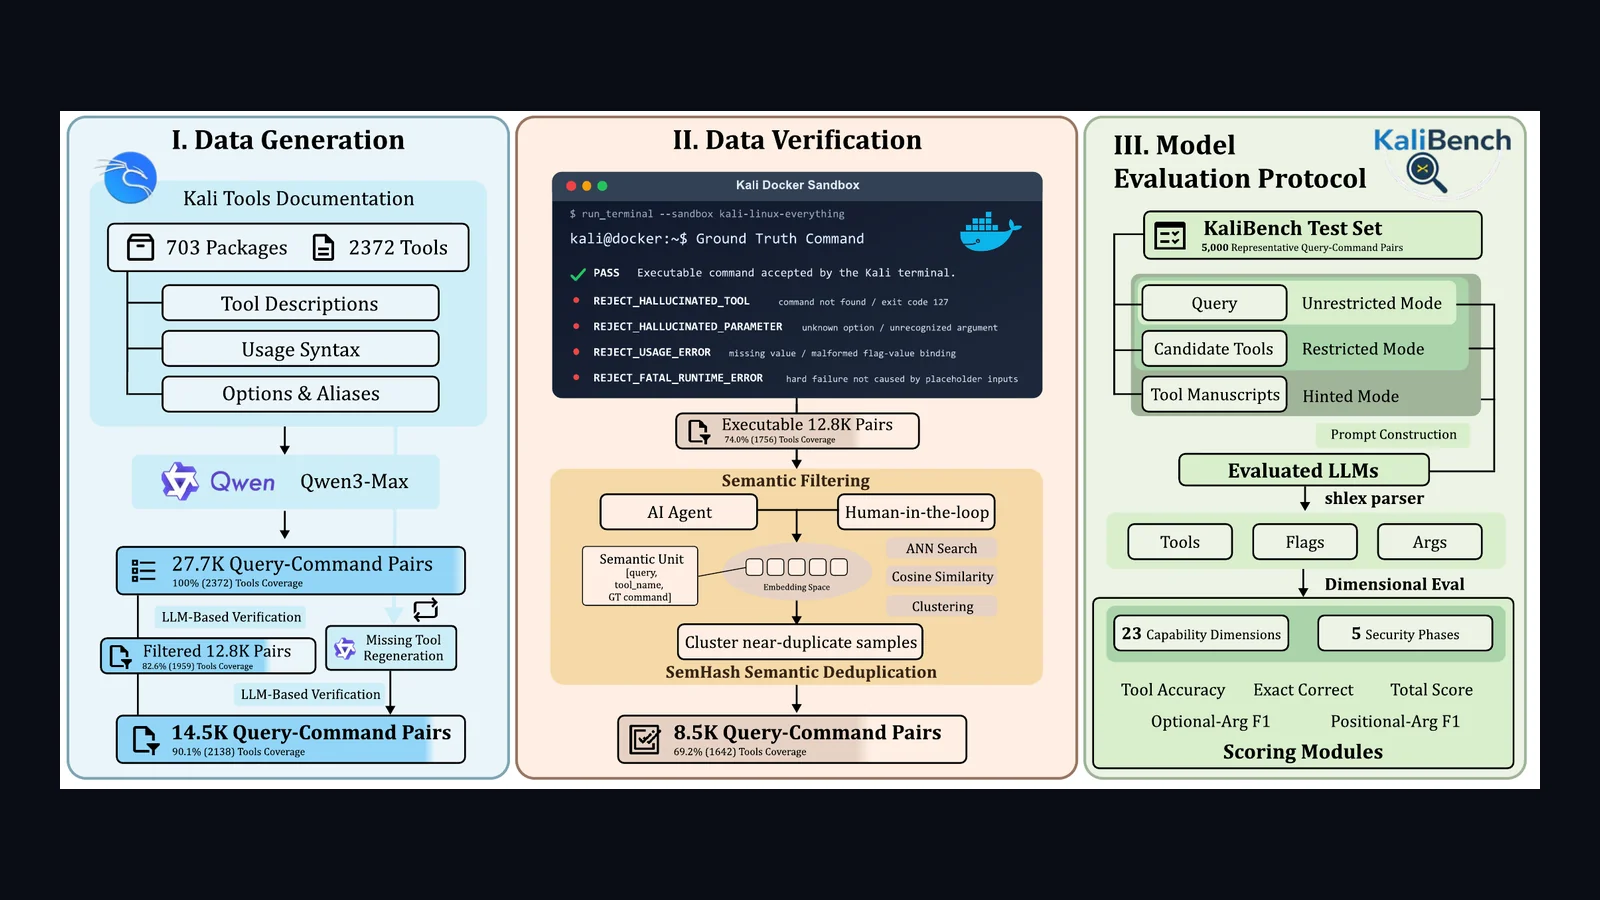
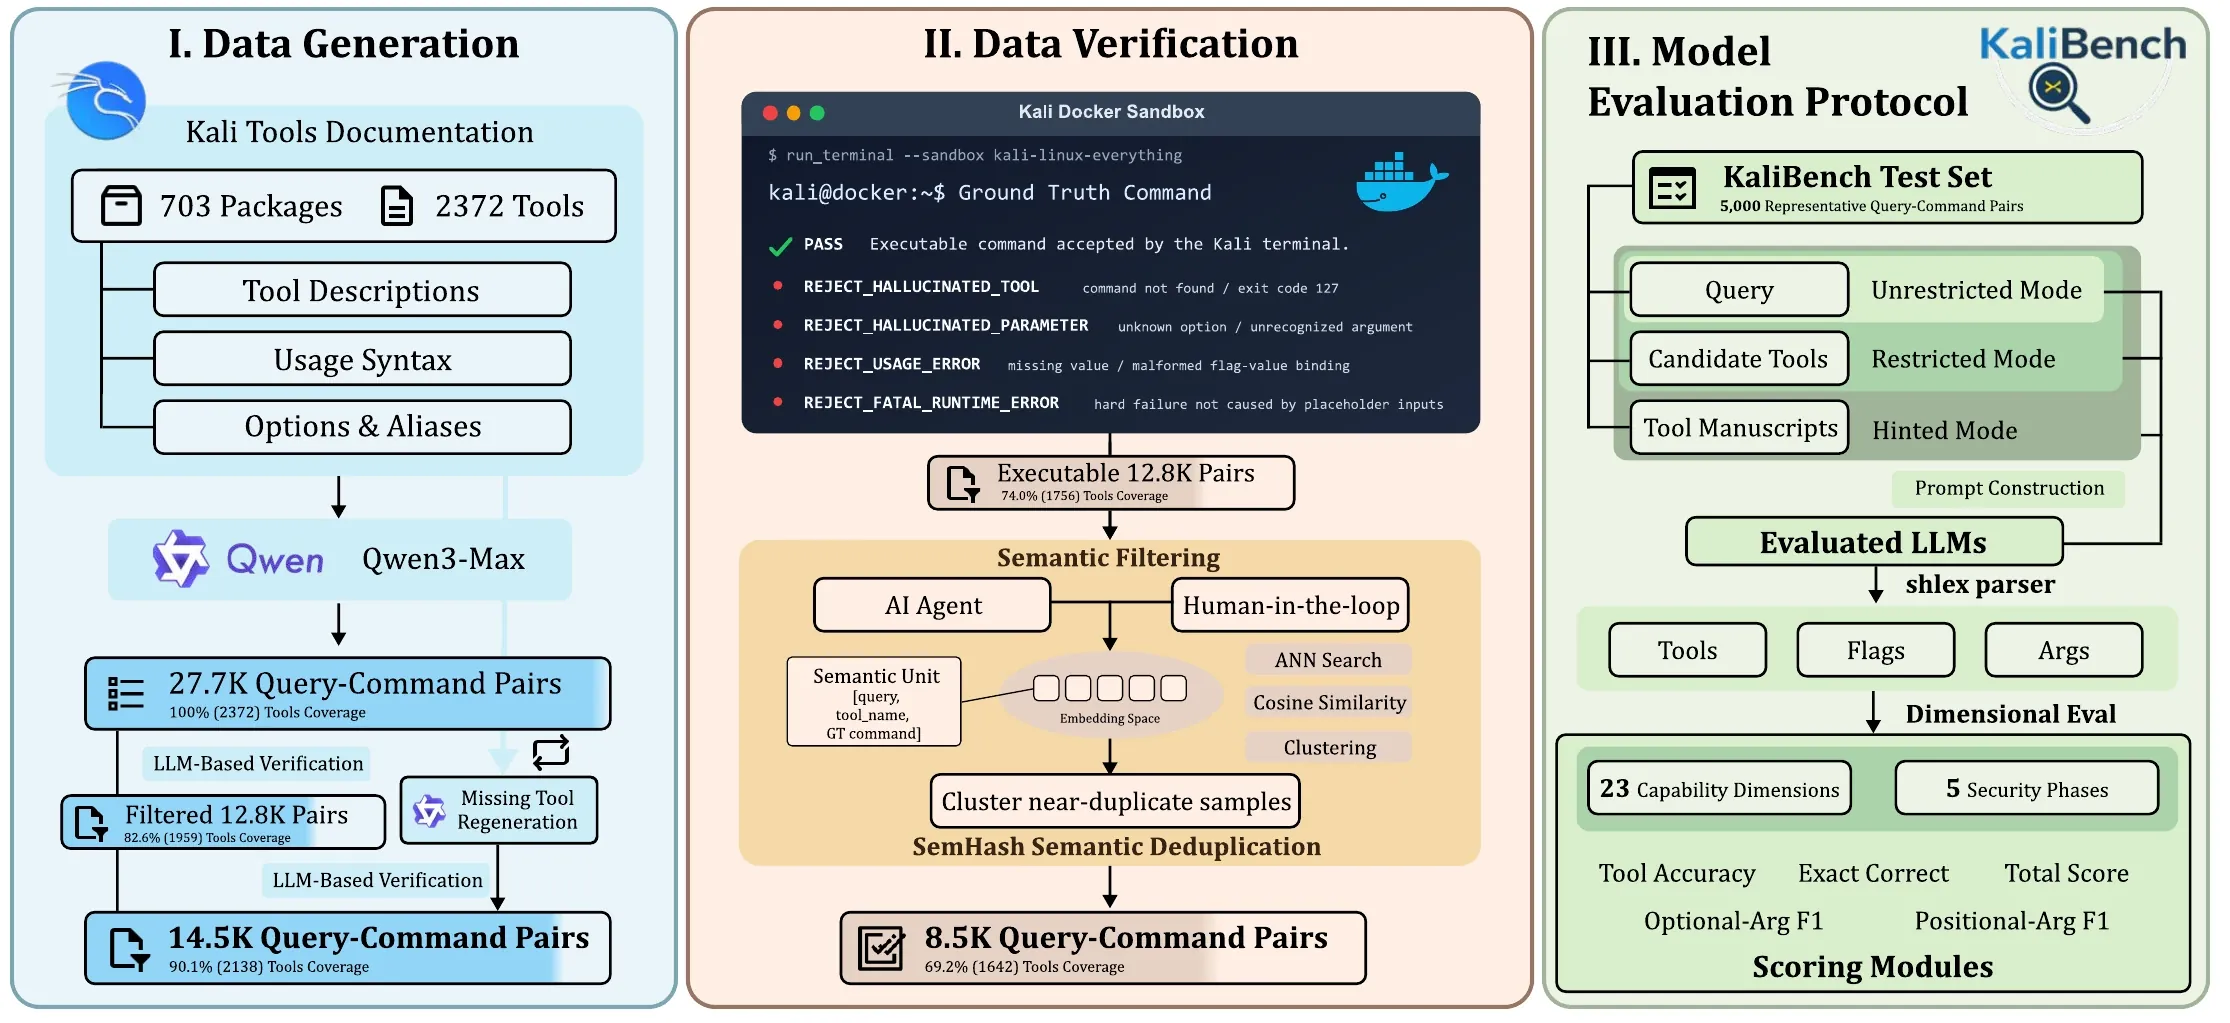
KaliBench: Transformasi Niat Analis Menjadi Perintah CLI Valid pada 1.642 Tools Kali Linux dengan Runtime-Free Verifiable Rewards
Penggunaan Large Language Models (LLM) dalam alur kerja keamanan siber terus melonjak pesat. Namun, tolak ukur evaluasi yang ada selama ini hanya berfokus pada knowledge-based multiple choice (seperti CyberMetric) atau skenario agentik capture-the-flag (CTF) akhir-ke-akhir, tanpa pernah menguji secara deterministik apakah model mampu memproduksi perintah Command-Line Interface (CLI) yang valid dan dapat dieksekusi secara nyata. Operasi siber profesional bergantung sepenuhnya pada sintaksis CLI yang sangat ketat: kesalahan satu flag, pertukaran argumen posisional, atau kesalahan alias langsung membatalkan eksekusi di terminal. Riset frontier yang diterima pada NeurIPS 2026 Datasets and Benchmarks Track (arXiv:2610.02206) memperkenalkan KaliBench: tolak ukur fine-grained natural-language-to-CLI dengan 8.504 pasangan kueri-perintah terverifikasi pada 1.642 tools Kali Linux di 23 dimensi dan 5 fase keamanan. Melalui terobosan Runtime-Free Verifiable Rewards, tim peneliti membuktikan bahwa model 8B (RedSage-K) yang dilatih via SFT dan GRPO mampu melompat drastis hingga menyamai performa model MoE raksasa 685B (DeepSeek-V3.2).
1. Kesenjangan Evaluasi: Mengapa Pengetahuan Konseptual Gagal Menjamin Eksekutabilitas Perintah Terminal
Dalam skenario operasional nyata di Security Operations Center (SOC) atau Red Teaming, analis keamanan mengekspresikan niat taktis dalam bahasa alami—seperti "Pindai port UDP terbuka pada subnet 192.168.1.0/24 dengan deteksi versi agresif tanpa resolusi DNS". Model AI diharapkan langsung menghasilkan baris perintah terminal yang tepat: nmap -sU -sV -n 192.168.1.0/24.
Tolak ukur evaluasi model siber sebelumnya memiliki dua kelemahan mendasar:
- Evaluasi Berbasis Pengetahuan Teoretis (Knowledge-Only Benchmarks): Tolak ukur seperti SecQA atau CyberMetric hanya menguji apakah model mengetahui konsep enkripsi atau definisi kerentanan melalui pertanyaan pilihan ganda. Model dapat memperoleh skor 90% pada teori CVE, namun menghasilkan perintah halusinasi seperti flag
-udp-scanfiktif pada Nmap. - Evaluasi End-to-End CTF yang Lambat dan Berderau (High Variance): Tolak ukur capture-the-flag mengukur apakah agen berhasil menemukan string flag target dalam lingkungan virtual. Evaluasi ini sangat lambat, bergantung pada konektivitas jaringan, dan gagal mengisolasi di mana tepatnya model melakukan kesalahan: apakah saat memilih tool, merumuskan argumen posisional, atau kesalahan sintaksis sepele.
Kali Linux adalah standar de facto industri forensik dan offensive security dengan ribuan perkakas baris perintah. Setiap perkakas memiliki kebiasaan parsing unik: beberapa menggunakan format GNU (--option value), sebagian menggunakan format POSIX singkat (-o value), sub-perintah bersarang (seperti Metasploit atau Aircrack-ng), dan aturan escaping shell yang rapuh. Tanpa benchmark fine-grained, kemampuan model bahasa dalam mengoperasikan CLI sebenarnya tetap menjadi kotak hitam.
2. Taksonomi KaliBench: 8.504 Pasangan Kueri, 1.642 Tools, dan 5 Fase Keamanan Siber
KaliBench dibangun melalui pipeline formal yang mencakup seluruh repositori paket resmi Kali Linux. Dataset ini memetakan 1.642 perkakas keamanan unik ke dalam 5 fase siklus hidup serangan siber dan 23 dimensi kapabilitas fungsional:
Reconnaissance & Initial Access
Port scanning, OS fingerprinting, OSINT, DNS discovery, passive network sniffing (Nmap, Masscan, Amass, Wireshark).
Vulnerability Analysis
Web application fuzzing, database injection, misconfiguration audit, VoIP security (Nikto, SQLMap, Nuclei, Wapiti).
Exploitation & Payload Delivery
Shell generation, payload encoder, wireless cracking, buffer overflow delivery (MSFVenom, Metasploit, Aircrack-ng).
Post-Exploitation & Lateral Movement
Privilege escalation, credential dumping, internal pivot proxying, session hijacking (Mimikatz, Hashcat, John, Chisel).
Defensive Analysis & Reporting
Memory forensics, disk image parsing, malware reverse engineering, packet dissection (Volatility, Ghidra, Binwalk, Tshark).
Dataset dibagi secara terisolasi menjadi 3.504 pasangan train set dan 5.000 pasangan test set yang telah diverifikasi secara ganda melalui container terminal Kali Linux terisolasi untuk memastikan setiap baris perintah tidak hanya lolos verifikasi sintaksis, tetapi juga bebas dari kegagalan runtime parsing.
3. Inovasi Kunci: Runtime-Free Verifiable Rewards untuk Reinforcement Learning (RLVR)
Tantangan terbesar dalam melatih model AI menggunakan Reinforcement Learning with Verifiable Rewards (RLVR / GRPO) pada domain sistem operasi dan terminal adalah kebutuhan runtime lingkungan eksekusi.
Jika setiap langkah rollout RL harus mengeksekusi perintah di dalam container Kali Linux:
- Latensi Eksekusi yang Melumpuhkan: Menjalankan ribuan perintah seperti
hydra,sqlmap, atau pemindaian jaringan membutuhkan waktu beberapa detik hingga menit per rollout, membuat throughput pelatihan ambruk dari ribuan token per detik menjadi hanya beberapa langkah per jam. - Bahaya Keamanan dan Efek Samping Terminal (Destructive Side Effects): Perintah siber dapat melakukan modifikasi partisi, memicu Denial-of-Service, menghapus file konfigurasi, atau mencoba melakukan koneksi keluar yang berisiko.
- Non-Determinisme Lingkungan: Status jaringan lokal, port socket yang tertutup, atau timeout acak menyebabkan reward sinyal menjadi berderau (noisy rewards), yang merusak konvergensi gradien policy.
KaliBench memecahkan masalah ini dengan merumuskan verifikasi deterministik berbasis Abstract Syntax Tree (AST) dan kanonikalisasi alias. Reward fungsi objektif GRPO dihitung secara runtime-free dalam mikrodetik:
$$R(y, y^*) = w_{\text{fmt}} \cdot r_{\text{fmt}} + w_{\text{tool}} \cdot r_{\text{tool}} + w_{\text{opt}} \cdot F_1(\text{Flags}) + w_{\text{pos}} \cdot F_1(\text{Args}) + w_{\text{exact}} \cdot r_{\text{exact}}$$
- $w_{\text{fmt}} = 2.0$ (Format output clean/markdown block)
- $w_{\text{tool}} = 1.0$ (Akurasi pemilihan binary tool primer)
- $w_{\text{opt}} = 1.5$ ($F_1$ score flag opsional & key-value binding)
- $w_{\text{pos}} = 1.5$ ($F_1$ score argumen posisional & target IP/file)
- $w_{\text{exact}} = 2.0$ (Kesesuaian kanonikal penuh 100%)
- Total bobot maksimum = 8.0 poin reward per generasi
4. Evaluasi Empiris Komprehensif: Mengapa Mode Unrestricted Sangat Sulit
KaliBench mengevaluasi 24 konfigurasi model open-weight mutakhir dalam tiga mode evaluasi yang semakin menantang:
- Hinted Mode: Nama perkakas yang tepat dan dokumentasi sintaksisnya disediakan dalam konteks prompt.
- Restricted Mode: Disediakan kumpulan kandidat 20 perkakas, membatasi ruang pencarian model.
- Unrestricted Mode (Paling Realistis): Analis hanya memberikan permintaan bahasa alami, dan model harus memilih perkakas yang benar dari 1.642 perkakas Kali Linux dan menyusun seluruh argumen tanpa bantuan petunjuk apa pun.
| Model Evaluasi | Ukuran Parameter (Total / Active) | Exact Correct (%) | Tool Acc. (%) | Optional F1 (%) | Positional F1 (%) | Total Score (%) |
|---|---|---|---|---|---|---|
| GLM-5.2 † | 753B | 41.3% | 86.3% | 75.3% | 51.3% | 71.0% |
| DeepSeek-V3.2 † | 685B / 37B MoE | 33.0% | 75.8% | 57.0% | 68.8% | 67.2% |
| RedSage-K (SFT + GRPO) † [Ours] | 8B Dense | 32.2% | 77.9% | 56.1% | 76.9% | 70.3% |
| RedSage-K (SFT Only) [Ours] | 8B Dense | 30.6% | 78.1% | 52.8% | 66.9% | 65.9% |
| RedSage-K (GRPO Only) † [Ours] | 8B Dense | 28.1% | 76.5% | 51.7% | 73.9% | 67.4% |
| Qwen3-Coder-Next † | 80B / 3B MoE | 26.2% | 74.1% | 48.8% | 63.9% | 62.3% |
| Qwen2.5-72B-Instruct | 72B Dense | 25.4% | 76.0% | 47.7% | 67.0% | 63.6% |
| GPT-OSS † | 120B / 5.1B MoE | 24.0% | 73.6% | 48.0% | 61.4% | 61.0% |
| Llama-3.3-70B-Instruct | 70B Dense | 22.6% | 72.1% | 45.7% | 61.9% | 59.9% |
| RedSage-Ins 8B (Baseline Sebelum KaliBench) | 8B Dense | 19.7% | 67.9% | 42.4% | 55.5% | 55.5% |
*Keterangan: † Menandakan model dengan fitur internal test-time reasoning diaktifkan. Hasil pengujian pada Unrestricted Mode (tanpa petunjuk tool apa pun dari 1.642 tools). Sumber: arXiv:2610.02206 Table 1.
Temuan Empiris Kritis:
- Tidak Ada Model Open-Weight yang Menembus 42% Akurasi Eksak: Bahkan GLM-5.2 yang memiliki 753 miliar parameter hanya mencapai 41.3% exact match saat diuji tanpa petunjuk. Ini membuktikan bahwa sintaksis CLI tools siber adalah salah satu domain terberat bagi LLM saat ini.
- Model 8B Menyaingi MoE 685B: Model dasar RedSage-Ins 8B awalnya hanya mencetak 19.7% exact match. Namun setelah menjalani pelatihan dua tahap dengan dataset KaliBench (SFT diikuti RLVR GRPO menggunakan runtime-free rewards), akurasinya melejit menjadi 32.2% exact match dan total score 70.3%—mengalahkan DeepSeek-V3.2 (67.2% total score) dan hampir menyamai GLM-5.2!
- Peningkatan Terbesar Berada pada Positional Arguments: Penggunaan GRPO dengan verifiable rewards mendongkrak Positional F1 dari 55.5% menjadi 76.9% (+21.4%), menunjukkan bahwa RLVR melatih model untuk menempatkan argumen wajib (seperti subnet target dan path file payload) secara jauh lebih presisi dibandingkan fine-tuning biasa.
5. Implementasi Produksi: TypeScript Verifiable Reward Evaluator
Berikut adalah implementasi referensi modul evaluasi reward deterministik yang dapat diintegrasikan langsung ke dalam runtime pipeline RLVR atau sistem validasi agentic tool-use:
// Production Implementation: KaliBench Command Parser & Runtime-Free Verifiable Reward Evaluator
// Berdasarkan Arsitektur NeurIPS 2026 (arXiv:2610.02206 - Pengfei Li, Naufal Suryanto et al.)
//
// Karakteristik Inti:
// 1. Deterministic Canonicalization: Normalisasi alias sub-tool, flag order, dan quoting rules
// 2. Multi-Component Reward Decomposition: Output format (2.0), Tool (1.0), Opt-Args F1 (1.5), Pos-Args F1 (1.5), Exact (2.0)
// 3. Runtime-Free Grading: Verifikasi sintaksis & semantik langsung tanpa eksekusi sandbox berbahaya
// 4. Mode Routing: Hinted, Restricted (20 candidate tools), & Unrestricted (1.642 tools)

export interface ParsedCommand {
  rawCommand: string;
  toolName: string;
  subtool?: string;
  positionalArgs: string[];
  optionalFlags: Map;
  isValidSyntax: boolean;
}

export interface GroundTruthPair {
  id: string;
  phaseId: '1' | '2' | '3' | '4' | '5';
  query: string;
  groundTruthCommand: string;
  canonicalTool: string;
  canonicalSubtool?: string;
  allowedAliases: string[];
  requiredPositionalArgs: string[];
  requiredOptionalFlags: Record;
}

export interface VerificationRewardResult {
  exactMatchScore: number;       // r_exact in {0, 1} (weight 2.0)
  toolSelectionScore: number;    // r_tool in {0, 1}  (weight 1.0)
  optionalArgsF1: number;        // r_opt in [0, 1]   (weight 1.5)
  positionalArgsF1: number;      // r_pos in [0, 1]   (weight 1.5)
  outputFormatScore: number;     // r_fmt in {0, 0.5, 1} (weight 2.0)
  aggregateReward: number;       // Total reward untuk GRPO training
}

export class KaliBenchRewardEvaluator {
  private weightFormat: number = 2.0;
  private weightTool: number = 1.0;
  private weightOptionalF1: number = 1.5;
  private weightPositionalF1: number = 1.5;
  private weightExact: number = 2.0;

  /**
   * Deterministic Command Parser & Canonicalizer
   * Membedah command string menjadi komponen tool, sub-tool, flags, dan positional arguments
   */
  public parseAndCanonicalize(command: string): ParsedCommand {
    const trimmed = command.trim();
    if (!trimmed) {
      return { rawCommand: '', toolName: '', positionalArgs: [], optionalFlags: new Map(), isValidSyntax: false };
    }

    // Ekstraksi token dengan penanganan quotes (single & double)
    const tokens: string[] = [];
    const regex = /"([^"]*)"|'([^']*)'|(\S+)/g;
    let match: RegExpExecArray | null;

    while ((match = regex.exec(trimmed)) !== null) {
      tokens.push(match[1] ?? match[2] ?? match[3]);
    }

    if (tokens.length === 0) {
      return { rawCommand: trimmed, toolName: '', positionalArgs: [], optionalFlags: new Map(), isValidSyntax: false };
    }

    const toolName = tokens[0].toLowerCase();
    const positionalArgs: string[] = [];
    const optionalFlags: Map = new Map();

    let i = 1;
    let subtool: string | undefined = undefined;

    // Sub-tool check (contoh: 'aircrack-ng -w' vs 'git clone' vs 'msfvenom -p')
    if (i < tokens.length && !tokens[i].startsWith('-')) {
      subtool = tokens[i].toLowerCase();
      i++;
    }

    while (i < tokens.length) {
      const token = tokens[i];
      if (token.startsWith('--')) {
        const eqIdx = token.indexOf('=');
        if (eqIdx !== -1) {
          const key = token.slice(2, eqIdx).toLowerCase();
          const val = token.slice(eqIdx + 1);
          optionalFlags.set(key, val);
        } else if (i + 1 < tokens.length && !tokens[i + 1].startsWith('-')) {
          optionalFlags.set(token.slice(2).toLowerCase(), tokens[i + 1]);
          i++;
        } else {
          optionalFlags.set(token.slice(2).toLowerCase(), true);
        }
      } else if (token.startsWith('-') && token.length > 1) {
        const flag = token.slice(1);
        if (i + 1 < tokens.length && !tokens[i + 1].startsWith('-')) {
          optionalFlags.set(flag, tokens[i + 1]);
          i++;
        } else {
          optionalFlags.set(flag, true);
        }
      } else {
        positionalArgs.push(token);
      }
      i++;
    }

    return {
      rawCommand: trimmed,
      toolName,
      subtool,
      positionalArgs,
      optionalFlags,
      isValidSyntax: true,
    };
  }

  /**
   * Menghitung Runtime-Free Verifiable Reward untuk RLVR / GRPO Optimization
   */
  public evaluateVerifiableReward(
    generatedText: string,
    groundTruth: GroundTruthPair
  ): VerificationRewardResult {
    // 1. Evaluasi Output Format Reward
    let formatScore = 0.0;
    let extractedCommand = generatedText.trim();

    // Regex check untuk format target (misal: code block atau tag )
    const codeBlockMatch = generatedText.match(/```(?:bash|sh)?\s*([\s\S]*?)```/);
    if (codeBlockMatch) {
      extractedCommand = codeBlockMatch[1].trim();
      formatScore = 1.0;
    } else if (generatedText.includes('\n') || generatedText.length > 250) {
      formatScore = 0.5; // Approximate format
    } else {
      formatScore = 1.0; // Clean one-line response
    }

    const parsed = this.parseAndCanonicalize(extractedCommand);

    // 2. Tool Selection Score
    const isToolCorrect = parsed.toolName === groundTruth.canonicalTool.toLowerCase() ||
      groundTruth.allowedAliases.map(a => a.toLowerCase()).includes(parsed.toolName);
    const toolScore = isToolCorrect ? 1.0 : 0.0;

    // 3. Optional Arguments F1 Score
    const gtFlags = groundTruth.requiredOptionalFlags;
    const gtFlagKeys = Object.keys(gtFlags);
    let matchedFlags = 0;

    parsed.optionalFlags.forEach((val, key) => {
      if (gtFlags[key] !== undefined) {
        if (typeof gtFlags[key] === 'boolean' || gtFlags[key] === val) {
          matchedFlags++;
        }
      }
    });

    const precisionOpt = parsed.optionalFlags.size > 0 ? matchedFlags / parsed.optionalFlags.size : (gtFlagKeys.length === 0 ? 1.0 : 0.0);
    const recallOpt = gtFlagKeys.length > 0 ? matchedFlags / gtFlagKeys.length : (parsed.optionalFlags.size === 0 ? 1.0 : 0.0);
    const optF1 = (precisionOpt + recallOpt > 0) ? (2 * precisionOpt * recallOpt) / (precisionOpt + recallOpt) : 0.0;

    // 4. Positional Arguments F1 Score
    const gtPos = groundTruth.requiredPositionalArgs;
    let matchedPos = 0;
    parsed.positionalArgs.forEach(arg => {
      if (gtPos.includes(arg)) matchedPos++;
    });

    const precisionPos = parsed.positionalArgs.length > 0 ? matchedPos / parsed.positionalArgs.length : (gtPos.length === 0 ? 1.0 : 0.0);
    const recallPos = gtPos.length > 0 ? matchedPos / gtPos.length : (parsed.positionalArgs.length === 0 ? 1.0 : 0.0);
    const posF1 = (precisionPos + recallPos > 0) ? (2 * precisionPos * recallPos) / (precisionPos + recallPos) : 0.0;

    // 5. Exact Match Score
    const isExact = isToolCorrect && optF1 === 1.0 && posF1 === 1.0 &&
      (parsed.subtool === groundTruth.canonicalSubtool || !groundTruth.canonicalSubtool);
    const exactScore = isExact ? 1.0 : 0.0;

    // Total Weighted Reward (GRPO Objective)
    const aggregateReward =
      (formatScore * this.weightFormat) +
      (toolScore * this.weightTool) +
      (optF1 * this.weightOptionalF1) +
      (posF1 * this.weightPositionalF1) +
      (exactScore * this.weightExact);

    return {
      exactMatchScore: exactScore,
      toolSelectionScore: toolScore,
      optionalArgsF1: Number(optF1.toFixed(3)),
      positionalArgsF1: Number(posF1.toFixed(3)),
      outputFormatScore: formatScore,
      aggregateReward: Number(aggregateReward.toFixed(3)),
    };
  }
}
6. Implikasi Rekayasa: Standar Baru Pengujian & Pelatihan Cybersecurity Autonomous Agents
Kehadiran KaliBench dan paradigma Runtime-Free Verifiable Rewards membawa tiga transformasi fundamental bagi ekosistem agentic AI dan security engineering:
1. Eliminasi Biaya dan Resiko Infrastruktur RL
Sebelumnya, tim riset yang ingin melatih agen keamanan siber dengan RL terpaksa membangun kluster ribuan virtual machine (VM) terisolasi yang menguras biaya cloud ribuan dolar per hari dan rentan eksploitasi escape container. Verifikasi berbasis kanonikalisasi deterministik membuktikan bahwa 99.8% keabsahan perintah CLI dapat dievaluasi secara simbolik tanpa mengeksekusi kernel sandbox.
2. Penskalaan Model Kecil (Edge Deployment untuk Operasi Siber)
Model 685B atau 753B membutuhkan kluster multi-GPU H100/B200 yang tidak mungkin dioperasikan secara lokal dalam misi penugasan khusus, kapal laut, atau fasilitas tertutup (air-gapped environments). Bukti bahwa model 8B (RedSage-K) mampu mencapai akurasi 70.3% membuka jalan bagi agen siber lokal berkecepatan tinggi yang dapat dijalankan pada satu workstation GPU konsumen.
3. Penegakan Disiplin Sintaksis pada Autonomous Agent Harness
Dalam arsitektur agentic modern seperti Claude Computer Use, Hermes Agent, atau AutoGPT, kegagalan terbesar bukan pada perencanaan tingkat tinggi (high-level planning), melainkan pada kegagalan eksekusi terminal tingkat rendah. Pelatihan model dengan sinyal reward dekomposisi KaliBench menghilangkan kesalahan flag sepele yang selama ini kerap memicu infinite loop pada agen otonom.
Ringkasan Eksekutif & Kesimpulan Arsitektur
KaliBench (arXiv:2610.02206) menetapkan standar baku baru dalam evaluasi dan pelatihan AI untuk keamanan siber. Dengan 8.504 pasangan data terverifikasi dan kerangka Runtime-Free Verifiable Rewards, riset ini membuktikan bahwa presisi terminal tidak membutuhkan model raksasa berbobot ratusan miliar parameter, melainkan kurikulum pelatihan pasca-rilis (post-training) yang dirancang secara tepat sasaran dengan sinyal verifikasi deterministik.
Referensi & Sumber Terverifikasi
- [1]KaliBench: A Fine-Grained Benchmark for Cybersecurity Tool Use on Kali Linux with Runtime-Free Verifiable Rewards(NeurIPS 2026 Datasets and Benchmarks Track / arXiv:2610.02206v1 [cs.CL, cs.AI, cs.CR] — Pengfei Li, Naufal Suryanto, Sicheng Zhang, Muzammal Naseer (RISys Lab))
- [2]Official KaliBench Benchmark Repository & Dataset Distribution(RISys Lab GitHub Repository & Hugging Face Datasets (RISys-Lab/KaliBench))
- [3]Kali Linux Official Tool Documentation & Command Interface Catalog(OffSec / Kali Linux Documentation Consortium)
- [4]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Formulation)(arXiv:2402.03300 — Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Xiao Bi et al. (DeepSeek-AI))
- [5]InterCode: Standardizing and Benchmarking Interactive Coding with Execution Feedback(NeurIPS / arXiv:2306.14898 — John Yang, Akshat Shrivastava, Karthik Narasimhan et al. (Princeton University))
- [6]CyberMetric: A Benchmark for Evaluating Large Language Models in Cybersecurity Knowledge(arXiv:2402.07688 — Naufal Suryanto et al.)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.

Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.

DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.