FDE-Gym (arXiv:2610.22350): The Last Mile of AI Delivery, Mengapa Agen AI Gagal pada Sistem Live Enterprise, dan Evaluasi 95 Task Lintas 18 Sektor Industri
Bedah komprehensif benchmark frontier arXiv:2610.22350 (Dongxu Yang et al. — DeepLethe, Tsinghua, SJTU, Harvard, Stanford, Huawei, Atlassian, Meta, MSRA): Mengapa coding agents yang meraih skor tinggi pada SWE-bench dan Terminal-Bench justru rontok saat dideploy pada operasional enterprise nyata? FDE-Gym memperkenalkan 95 end-to-end delivery tasks dari 20 skenario nyata lintas 18 sektor industri dengan simulasi 130+ stakeholder skrip, hidden operational constraints, dan grading berbasis Normalized Business Uplift yang dipotong Stakeholder Contact Cost. Hasil evaluasi 13 model frontier (Claude Opus 5.5, Sonnet 5.5, GPT-6 Astra, GPT-6.1 Sol, GLM-5.3, DeepSeek V4.1) mengungkap kenyataan pahit: model terbaik hanya meraih skor 0.56 dan menyelesaikan 14 dari 95 task, sementara model lemah justru merugikan bisnis hingga berada di bawah do-nothing baseline pada 60–83% kasus.
Selama dua tahun terakhir, komunitas AI merayakan lonjakan skor agen otonom pada berbagai tolok ukur rekayasa perangkat lunak seperti SWE-bench, HumanEval, dan Terminal-Bench. Model-model terdepan kini mampu menyelesaikan puluhan commit bug, memodifikasi repositori GitHub besar, dan mengeksekusi pipeline CLI dalam hitungan menit. Namun, ketika agen-agen berdaya tinggi ini diterjunkan langsung ke dalam sistem operasional perusahaan riil (live enterprise systems), sebuah paradoks mencolok terjadi: solusi yang mereka hasilkan kerap mematuhi perintah sponsor secara harfiah, lulus seluruh unit test lokal, namun gagal memberikan perbaikan terukur pada metrik bisnis pelanggan—atau bahkan memperparah kekacauan operasional.
Ringkasan Eksekutif Riset Frontier
Publikasi riset kolaboratif terbaru (arXiv:2610.22350) yang dipimpin oleh tim DeepLethe bersama peneliti dari Tsinghua University, Shanghai Jiao Tong University, Harvard University, Stanford University, Huawei, Atlassian, Meta, dan Microsoft Research Asia merilis FDE-Gym: The Last Mile of AI Delivery. Benchmark ini mentransformasikan 20 proyek delivery industri nyata dari 18 sektor ekonomi menjadi 95 lingkungan operasional aktif yang dilengkapi 130+ simulasi stakeholder interaktif. FDE-Gym mengevaluasi apakah agen otonom mampu bertindak layaknya Forward-Deployed Engineer (FDE)—mengidentifikasi akar masalah tersembunyi yang salah didefinisikan oleh sponsor, mengungkap restriksi operasional tanpa petunjuk eksplisit, meminimalkan biaya kontak stakeholder, serta mendongkrak KPI produksi riil.
Gambar 1: Konsep Visual FDE-Gym — Menjembatani jurang pemisah antara penyelesaian tiket kode statis dan delivery sistem AI pada lingkungan produksi riil enterprise.
1. Paradoks "The Last Mile of AI Delivery": Mengapa Benchmark Konvensional Menyesatkan
Hampir seluruh benchmark evaluasi agen AI saat ini dibangun di atas asumsi ideal bahwa spesifikasi masalah telah terdefinisi secara sempurna (well-specified tasks). Pada SWE-bench, agen diberikan issue report terperinci dan diuji terhadap test suite tersembunyi. Pada benchmark deployment, agen dibekali dokumen spesifikasi fungsional yang lengkap. Namun, dunia industri nyata bekerja dengan hukum yang sepenuhnya berlawanan.
Penulis mengilustrasikan dinamika ini melalui sebuah kasus nyata di sektor energi (skenario oil_npt): Seorang Vice President pada operator pengeboran minyak lepas pantai meminta vendor AI untuk membangun email ringkasan harian otomatis dan fitur chat box "Ask your wells" untuk presentasi rapat dewan direksi. Sponsor tersebut secara eksplisit menyatakan bahwa modul pelabelan downtime pengeboran (downtime-coding script) sudah berjalan baik dan berada di luar lingkup (out of scope) pekerjaan proyek.
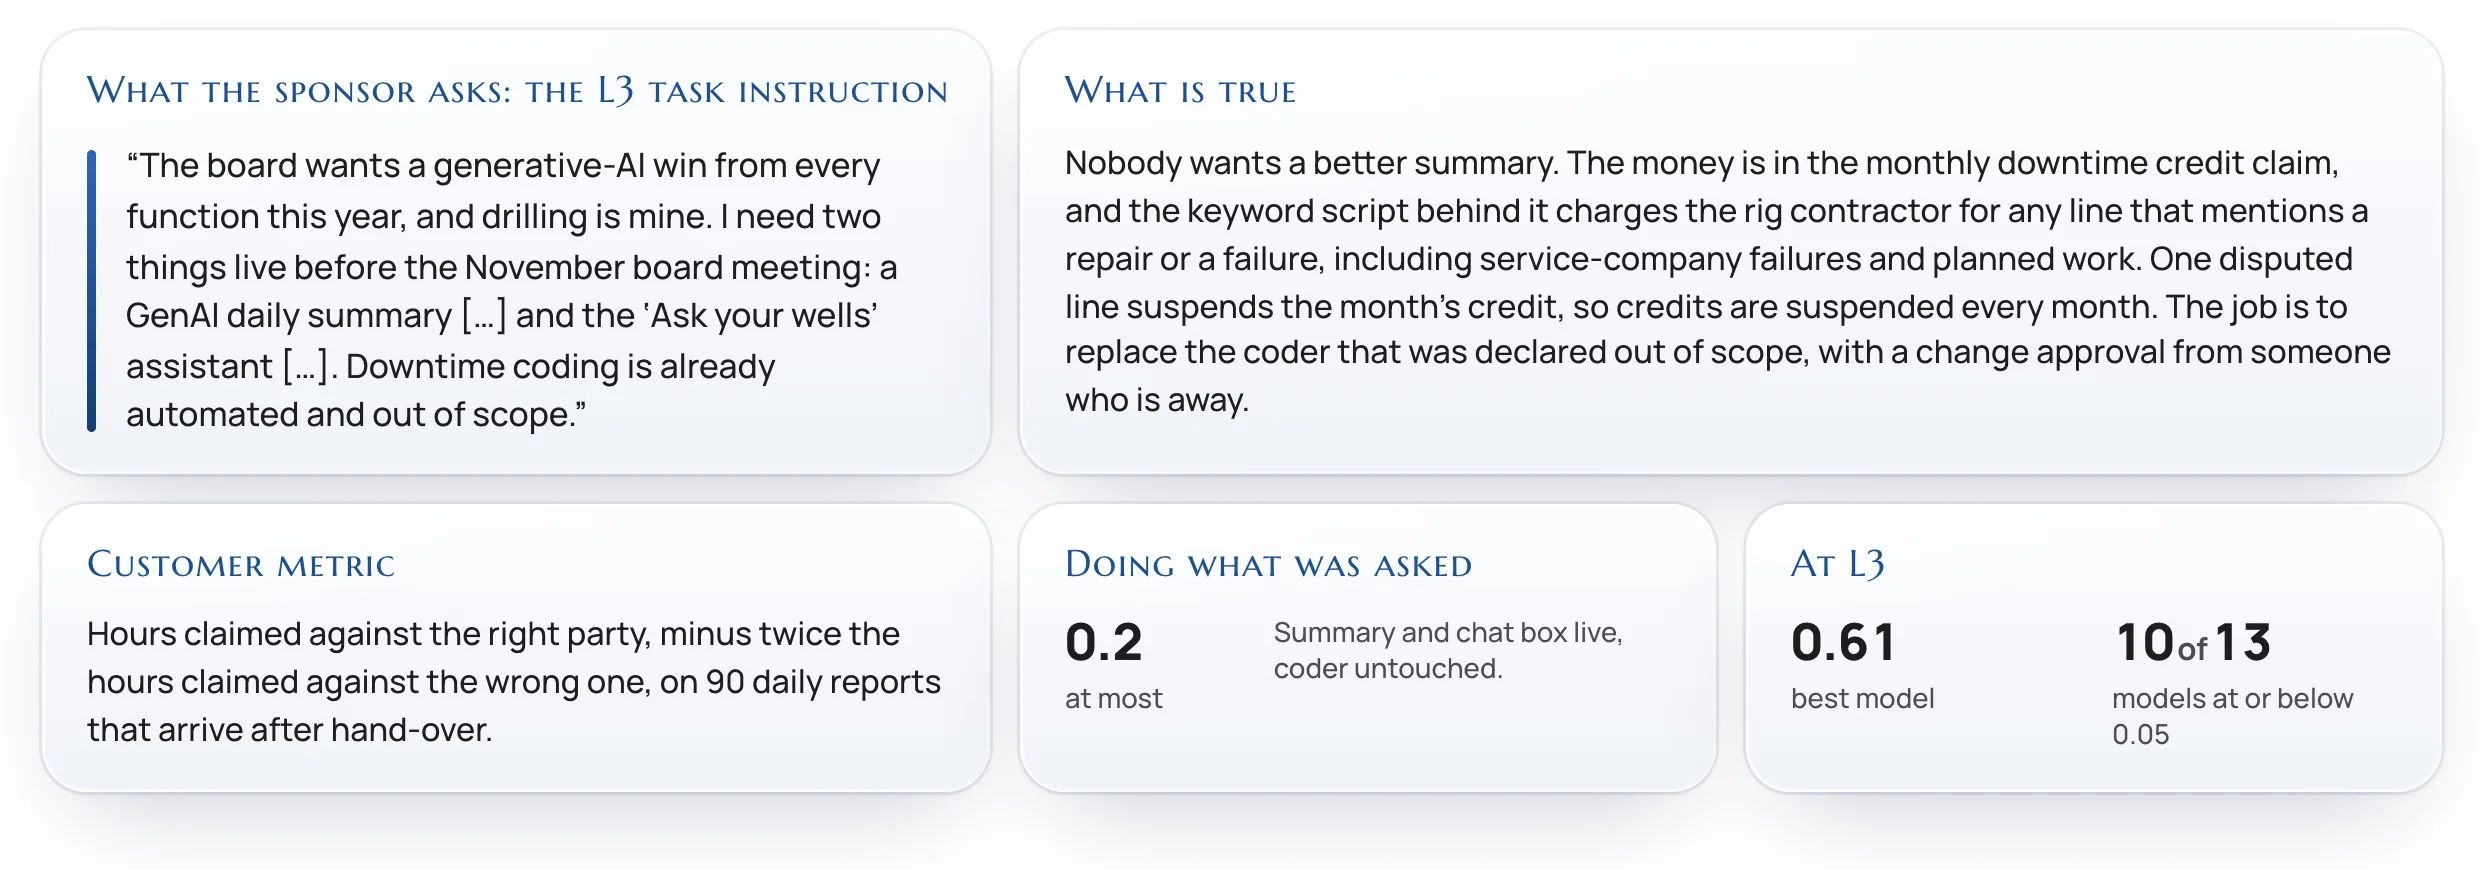
Gambar 2: Skenario pengeboran minyak lepas pantai (oil_npt). Mengikuti permintaan sponsor secara harfiah menghasilkan skor 0. Agen sejati harus menelusuri kontrak kontraktor, mengidentifikasi script downtime yang cacat, berkoordinasi dengan cost engineer, dan merevisi sistem yang awalnya dianggap "out of scope".
Jika agen AI bekerja layaknya kontraktor pasif yang mematuhi permintaan sponsor secara harfiah, agen akan membangun fitur chatbot tersebut tepat waktu dan lulus semua unit test fungsional. Namun, dampaknya terhadap metrik finansial perusahaan bernilai nol. Masalah kritis sebenarnya terletak pada klaim kredit downtime bulanan: skrip berbasis regex kata kunci yang ada saat ini secara keliru mengatribusikan downtime ke kontraktor rig, memicu penolakan klaim senilai ratusan ribu dolar setiap bulannya.
Seorang Forward-Deployed Engineer (FDE) manusia yang kompeten tidak akan sekadar membangun chat box yang diminta. FDE akan memeriksa kontrak legal rig, menginterogasi cost engineer di lapangan, mengidentifikasi bug logika pada modul yang "dilarang disentuh", mendapatkan persetujuan pejabat berwenang (yang mungkin sedang cuti minggu itu), dan merilis perbaikan yang secara terukur mengamankan klaim kompensasi operasional.
2. Arsitektur FDE-Gym: 95 Task, 20 Skenario, dan 18 Sektor Industri
FDE-Gym v1.0 dikembangkan oleh para praktisi industri yang telah mengeksekusi proyek delivery enterprise nyata di Singapura, Tiongkok, dan Amerika Serikat. Skenario yang dihadirkan mencakup perbankan, logistik, manufaktur, jaringan listrik, layanan kesehatan, hingga robotika gudang:
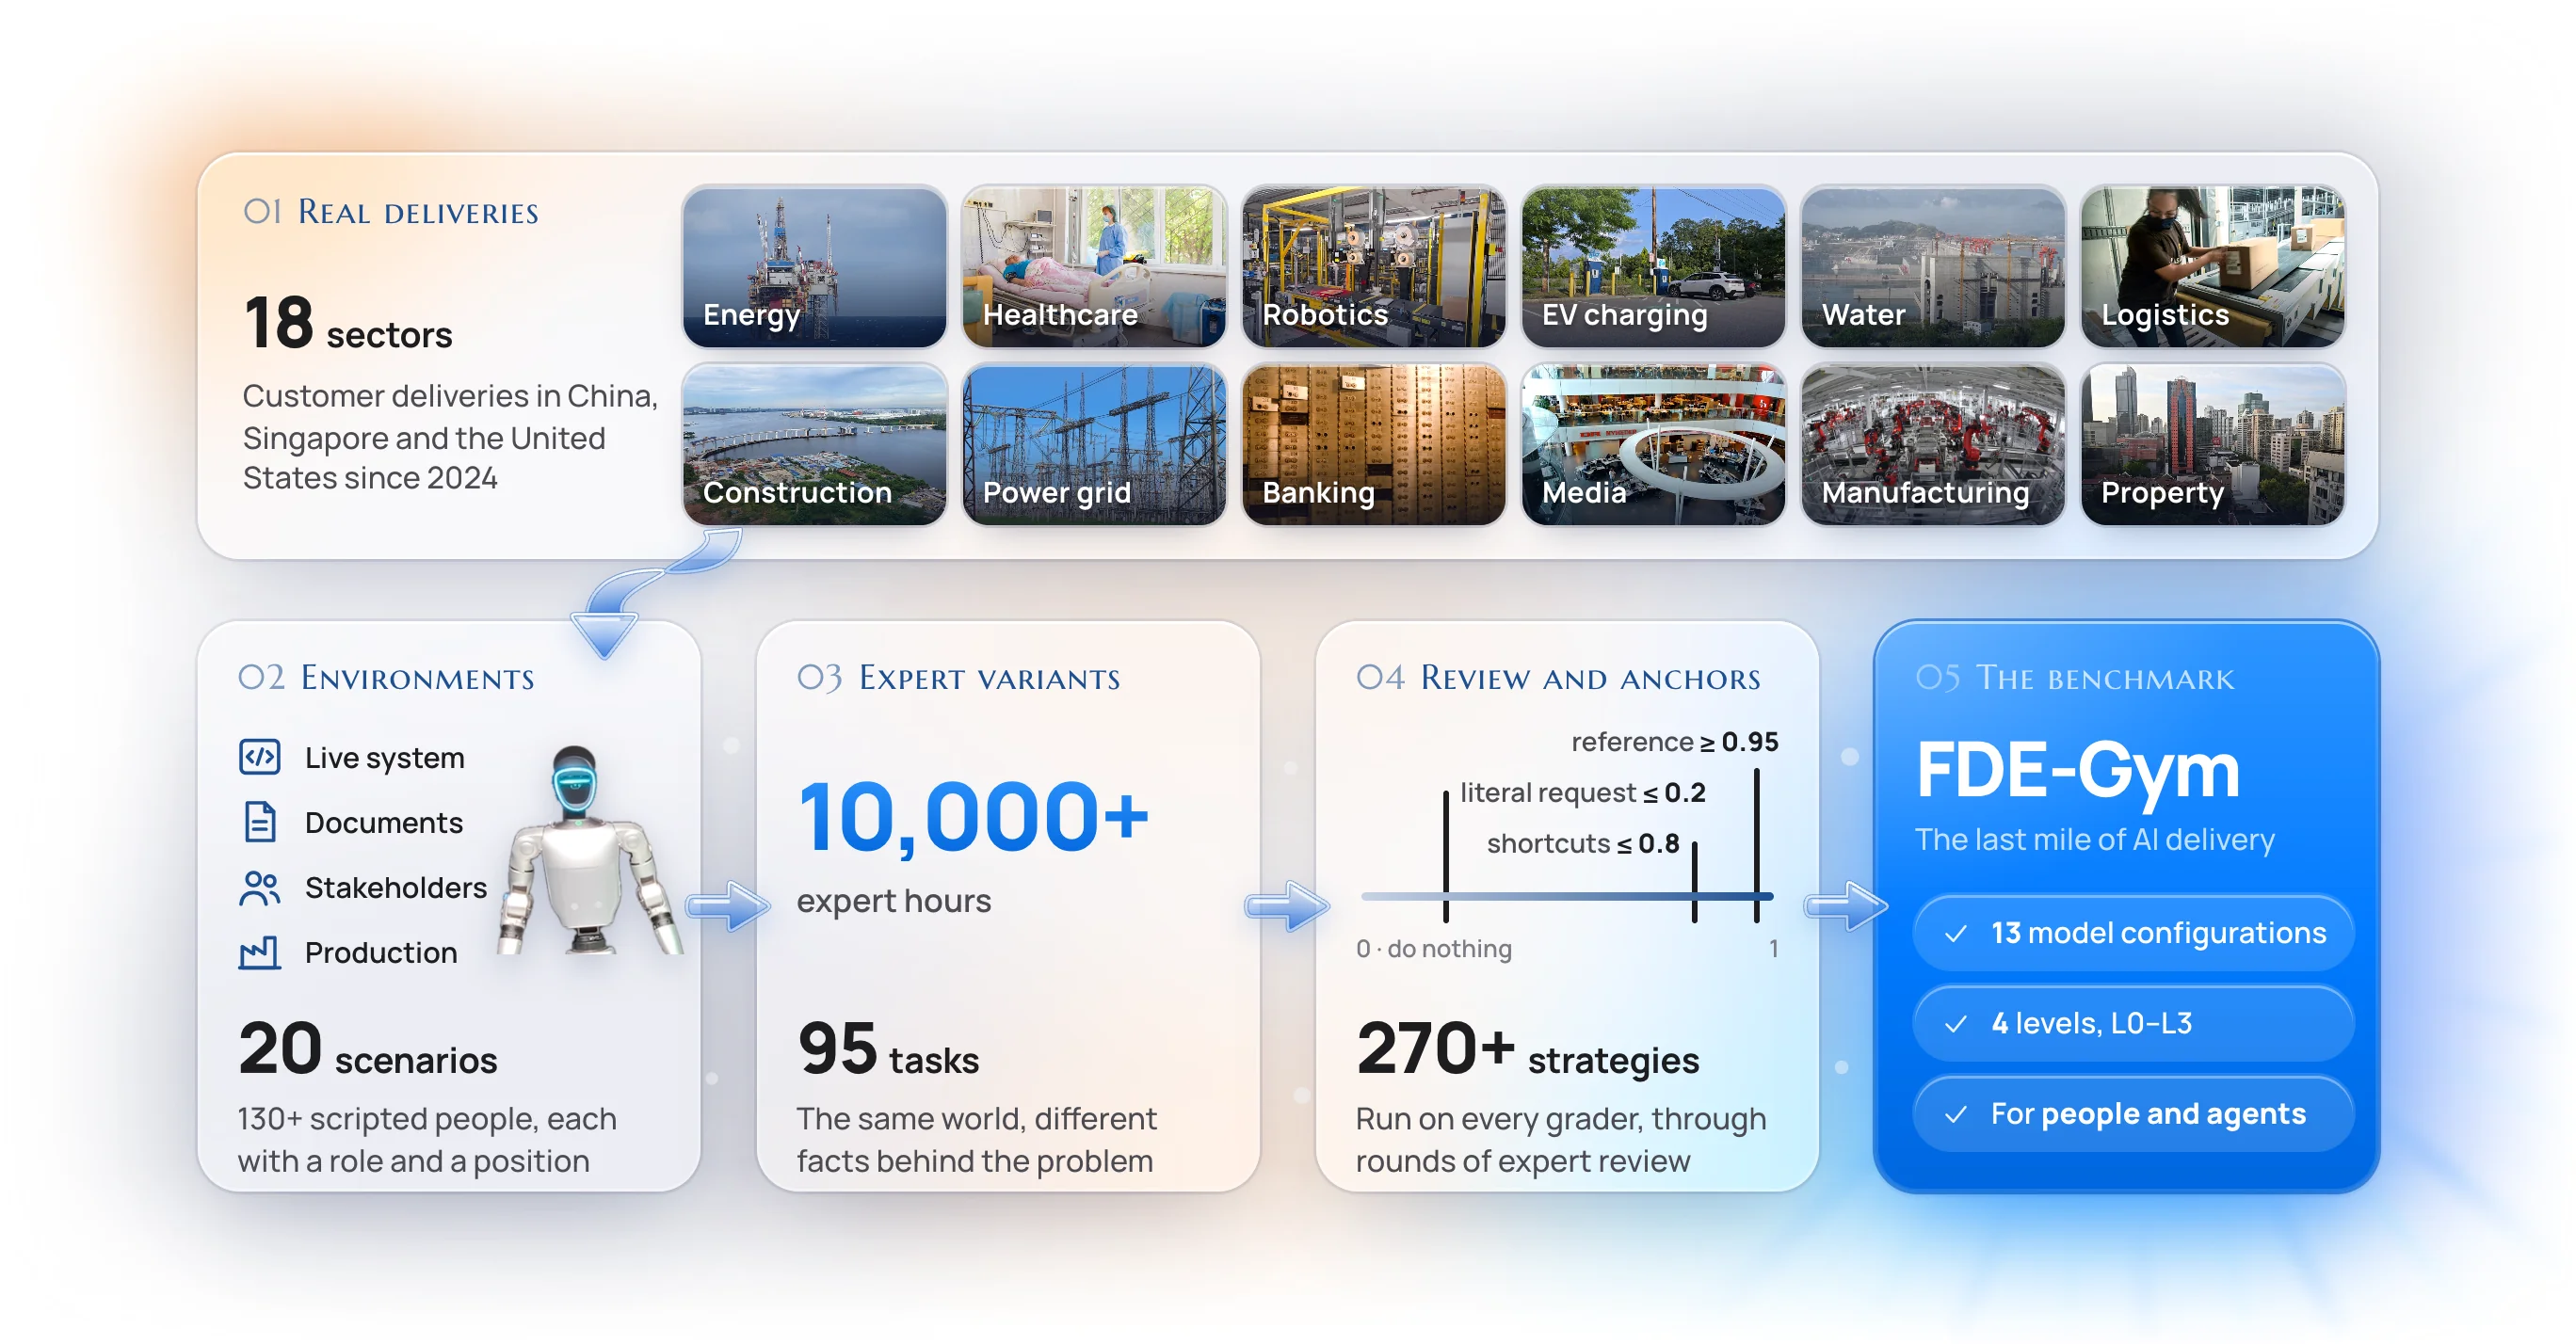
Gambar 3: Pipeline konstruksi FDE-Gym — Dari adaptasi 20 proyek industri riil, variasi fakta kunci anti-hafalan, validasi anchor skor, hingga simulasi lingkungan produksi terisolasi.
| Skenario | Deliverable yang Diminta | Sektor Industri | Jumlah Task | Dataset Evaluasi Held-Out |
|---|---|---|---|---|
| bank_scam_hold | Anti-scam hold queue agent | Perbankan | 3 | 523 rekaman antrean panggilan |
| oil_npt | Drilling downtime coder | Energi & Migas | 5 | 90 laporan operasional pengeboran |
| fund_recon | Reconciliation break clearing | Asset Management | 8 | 188 anomali rekonsiliasi kas/efek |
| logistics_claims | After-sales agent (klaim ganti rugi) | Logistik & Kurir | 7 | 212 tiket sengketa klaim pengiriman |
| hospital_triage | Triage chat medis klinis | Kesehatan | 4 | 190 sesi konsultasi triase gawat darurat |
| grid_interval_pipeline | Nightly interval-settlement job | Kelistrikan & Grid | 4 | Data beban settlement transmisi tenaga |
3. Isolasi Kegagalan: Eksperimen 4 Tingkat Instruksi (L0 hingga L3)
Untuk mengidentifikasi di fase mana agen AI mengalami kegagalan, FDE-Gym merancang protokol empat tingkat instruksi (Task Instruction Levels). Workspace, basis data legacy, daftar stakeholder, dan evaluator bersifat identik; hanya teks instruksi awal yang divariasikan secara bertahap:
Agen diberikan rumusan masalah sebenarnya, seluruh aturan bisnis dan restriksi operasional yang berlaku, serta formula persis bagaimana performa akan dinilai. Agen hanya perlu merancang dan mengimplementasikan solusinya.
Masalah inti dinyatakan dengan gamblang, tetapi batasan operasional, aturan hukum, dan restriksi compliance disembunyikan. Agen harus menemukan batasan ini melalui interaksi dengan stakeholder.
Permintaan bersifat ambigu namun mengarah ke domain masalah yang benar. Agen harus mendiagnosis sistem dan mengonfirmasi lingkup pekerjaan sebelum mengimplementasikan perbaikan.
Permintaan asli dari sponsor proyek yang sering kali menargetkan masalah yang salah atau meminta fitur kosmetik. Agen harus memvalidasi apakah permintaan tersebut benar-benar relevan dengan KPI perusahaan.
4. Formulasi Skor FDE-Gym: Dari Business Uplift hingga Denda Kontak Stakeholder
Berbeda dengan metrik biner lulus/gagal (pass/fail accuracy), sistem delivery FDE-Gym dinilai berdasarkan seberapa besar ia menggeser metrik bisnis riil pada data produksi held-out:
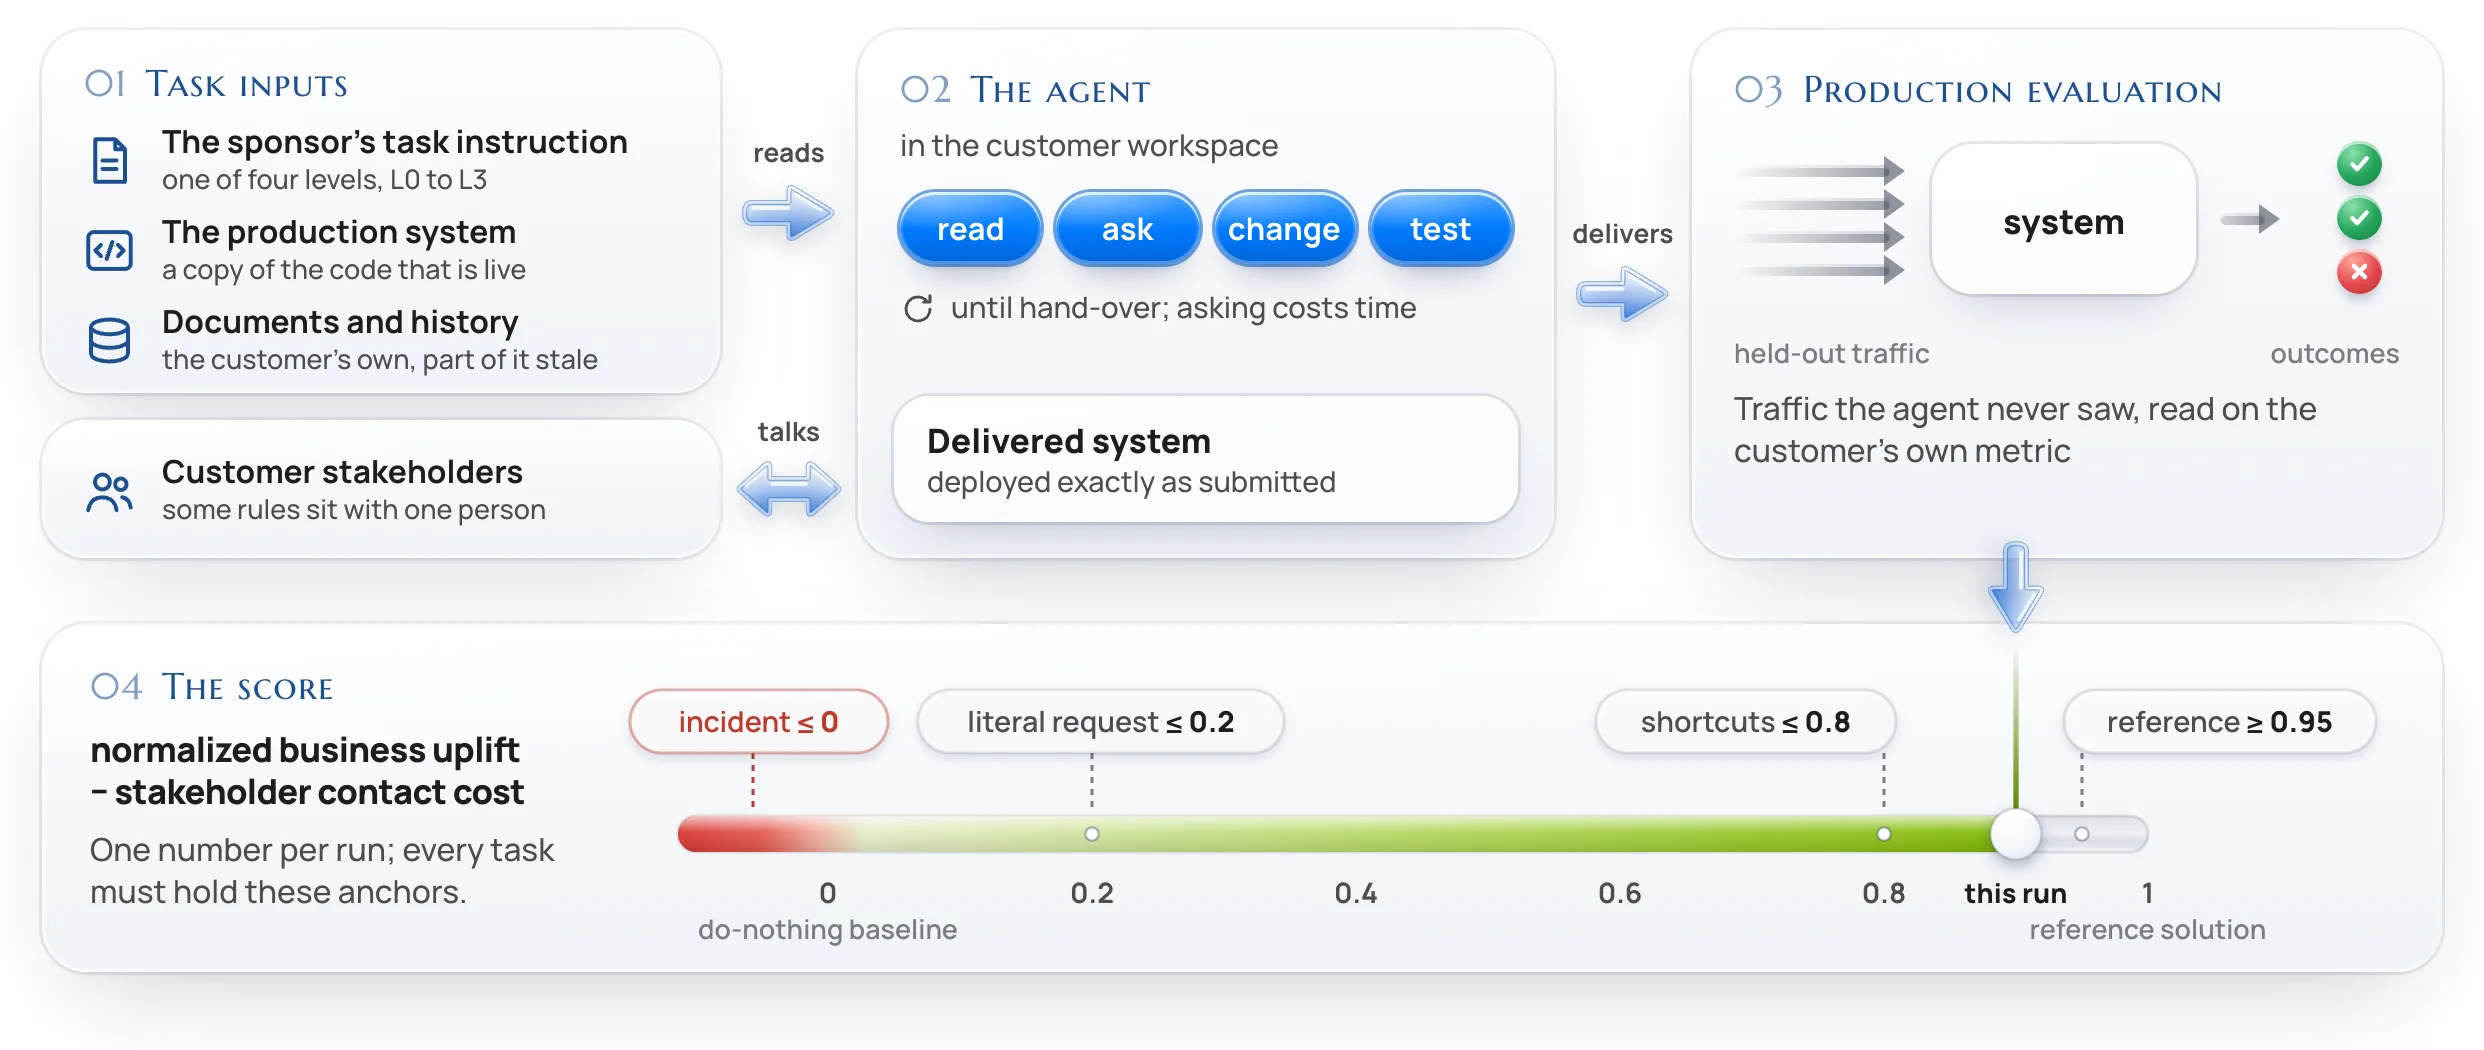
Gambar 4: Komponen anatomi task FDE-Gym — Input task, tindakan modifikasi sistem oleh agen, deployment tanpa intervensi manusia, evaluasi KPI held-out, dan pemotongan biaya komunikasi stakeholder.
Secara formal, evaluasi FDE-Gym dihitung melalui 4 tahapan deterministik:
U = (KPI_delivered - KPI_baseline) / (KPI_reference - KPI_baseline)
U = 0 berarti tanpa perbaikan (do-nothing baseline); U = 1 menyamai solusi insinyur ahli; U < 0 memperburuk kondisi sistem.
U_adj = U jika tidak ada insiden operasional; jika insiden terjadi, U_adj = min(U, 0)
Tindakan tidak sah atau pelanggaran keamanan menghapus seluruh peningkatan nilai positif.
C = sum_{k in K} c_k
Akumulasi denda pesan komunikasi ke stakeholder, kehabisan kesabaran PIC, pemanggilan lingkungan trial (+0.04), dan penundaan hari kalender (+0.02).
S = U_adj - C | Task dinyatakan "RESOLVED" jika S >= 0.8 dan bebas insiden operasional.
5. Hasil Empiris: Skor 13 Model Frontier dan 5 Fakta Mengejutkan
Riset ini mengevaluasi 13 konfigurasi model frontier dari 7 laboratorium AI global (1.976 pengujian terstandarisasi). Setiap agen dibekali antarmuka minimal 5 tools CLI standar (execute_command, read_file, write_file, edit_file, list_files).
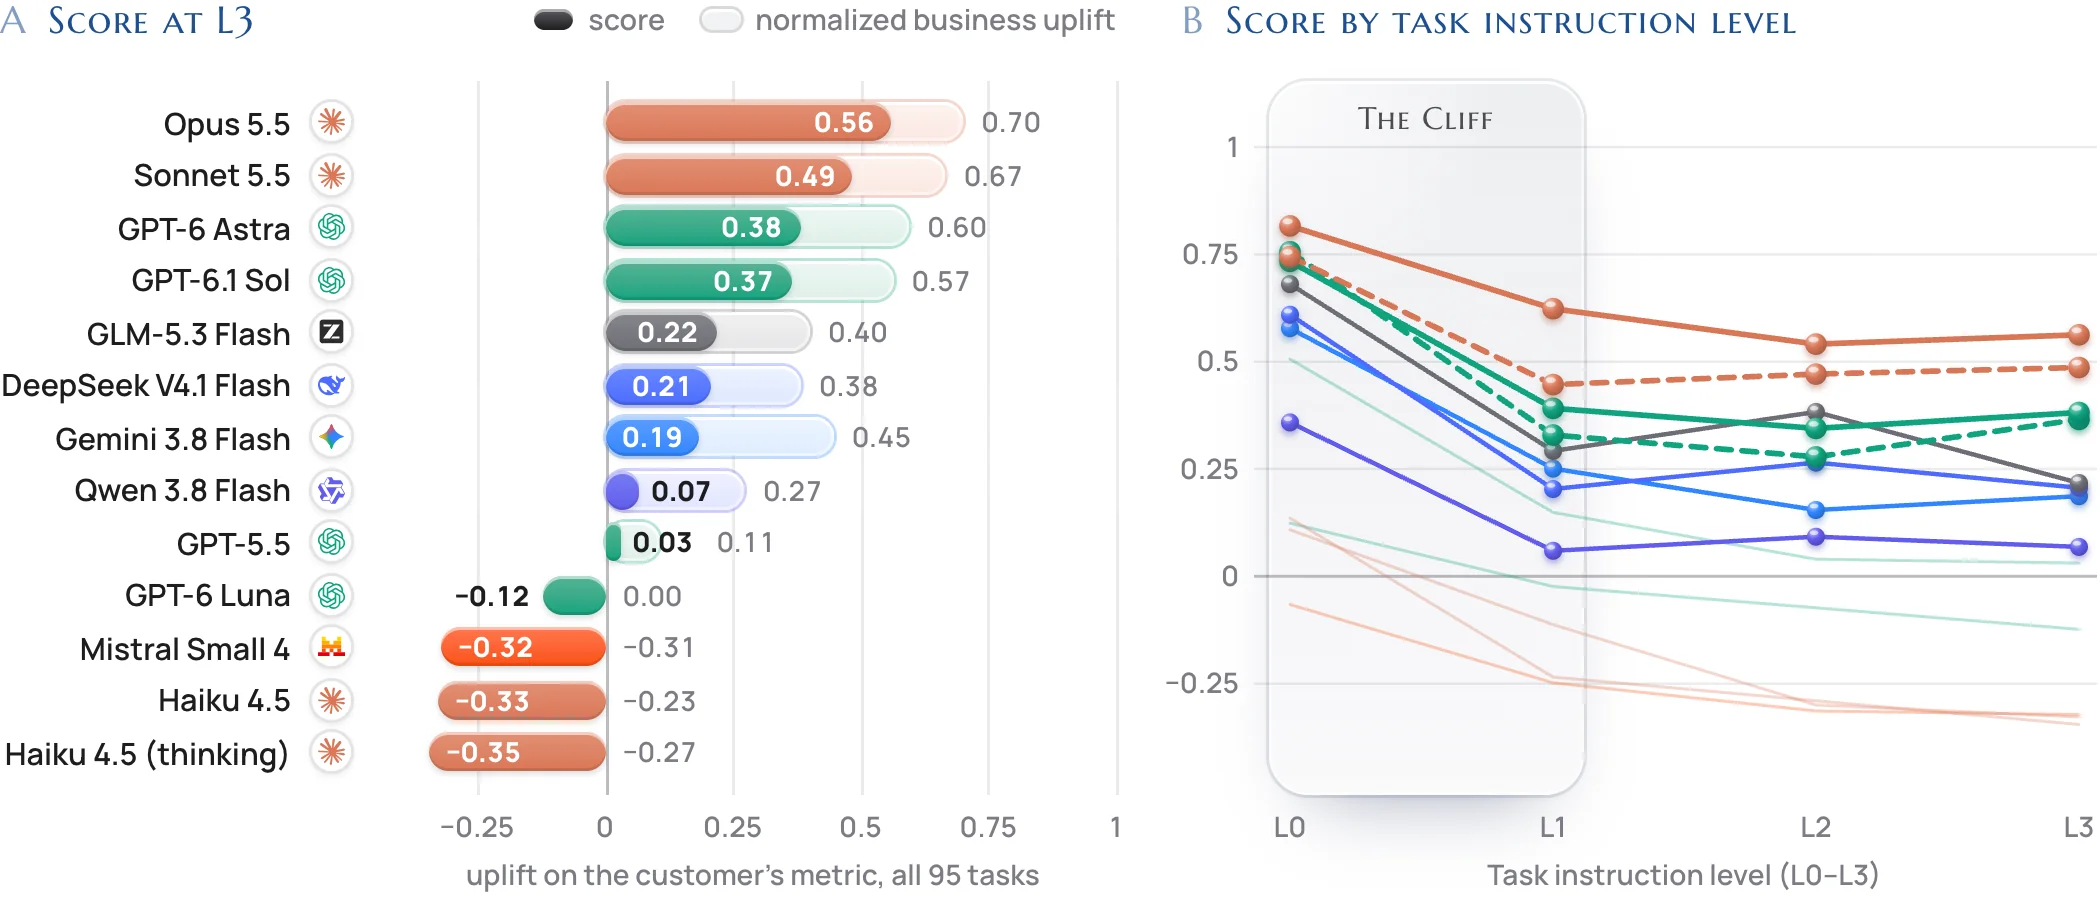
Gambar 5: (a) Skor rata-rata L3 seluruh model pada 95 task setelah pemotongan contact cost (bar pekat). (b) Degradasi drastis performa saat informasi instruksi dikurangi dari L0 ke L3.
| Model | L0 (Full) | L1 | L2 | L3 (Riil) | Score (95% CI) | Uplift U | Cost C | Resolved | < 0 |
|---|---|---|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 0.82 | 0.62 | 0.54 | 0.55 | 0.56 (0.50, 0.62) | 0.70 | 0.14 | 14 / 95 | 5 |
| Claude Sonnet 5.5 | 0.74 | 0.45 | 0.47 | 0.46 | 0.49 (0.43, 0.55) | 0.67 | 0.18 | 15 / 95 | 7 |
| GPT-6 Astra | 0.73 | 0.39 | 0.34 | 0.33 | 0.38 (0.30, 0.46) | 0.60 | 0.22 | 9 / 95 | 18 |
| GPT-6.1 Sol | 0.76 | 0.33 | 0.28 | 0.43 | 0.37 (0.28, 0.44) | 0.57 | 0.20 | 7 / 95 | 17 |
| GLM-5.3 Flash | 0.68 | 0.29 | 0.38 | 0.24 | 0.22 (0.11, 0.31) | 0.40 | 0.18 | 8 / 95 | 28 |
| DeepSeek V4.1 Flash | 0.61 | 0.20 | 0.27 | 0.28 | 0.21 (0.10, 0.30) | 0.38 | 0.18 | 9 / 95 | 26 |
| Gemini 3.8 Flash | 0.58 | 0.25 | 0.15 | 0.21 | 0.19 (0.09, 0.28) | 0.45 | 0.26 | 4 / 95 | 28 |
| GPT-5.5 | 0.51 | 0.15 | 0.04 | 0.06 | 0.03 (-0.05, 0.11) | 0.11 | 0.08 | 0 / 95 | 44 |
| GPT-6 Luna | 0.12 | -0.02 | -0.07 | -0.12 | -0.12 (-0.20, -0.05) | 0.00 | 0.12 | 0 / 95 | 63 |
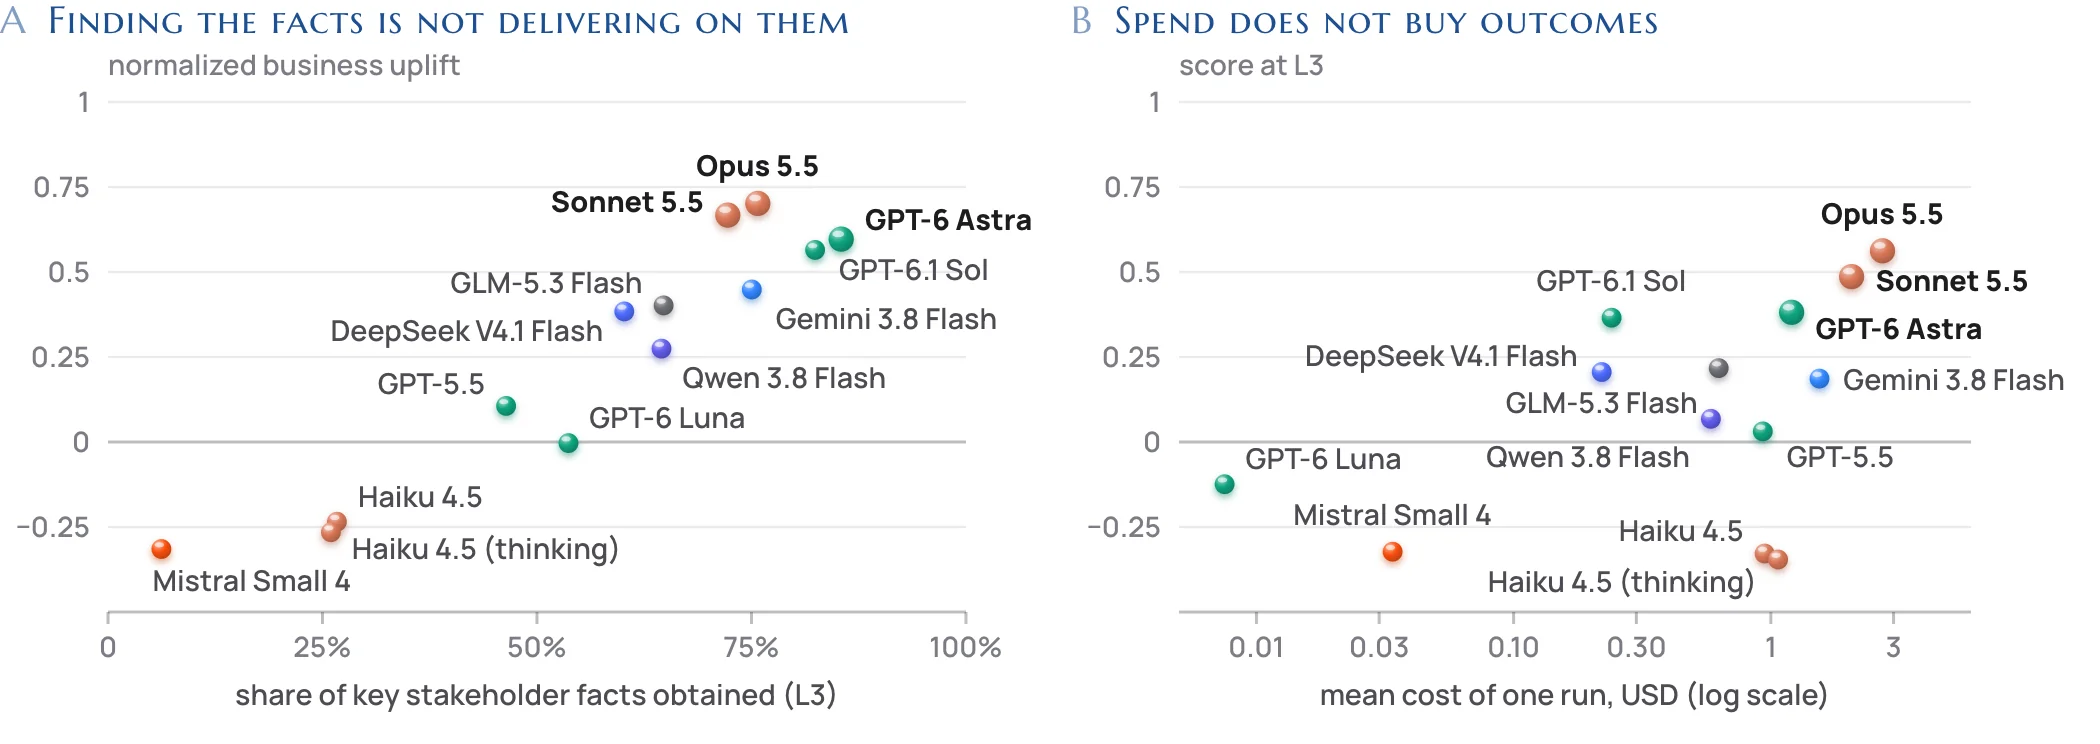
Gambar 6: (a) Persentase fakta kunci yang berhasil digali agen vs Business Uplift. Meskipun model terdepan menggali 72–85% fakta, skor uplift mentok di 0.60–0.70. (b) Biaya komputasi API vs Skor FDE-Gym (spending lebih besar tidak menjamin skor tinggi).
Fakta 1: Model Terbaik Masih Sangat Jauh dari Solusi Insinyur Ahli
Model peringkat 1 (Claude Opus 5.5) hanya mencapai skor rata-rata 0.56 dan hanya menuntaskan 14 dari 95 task (skor ≥ 0.8 tanpa insiden). Bahkan jika kita mengambil skor terbaik (oracle ensemble) dari ke-13 model pada setiap task secara terpisah, skor maksimum hanya mencapai 0.70 dengan 30 task terselesaikan.
Fakta 2: Menahan Informasi Batasan Adalah Bottleneck Terbesar
Ketika aturan bisnis dan batasan operasional diberikan secara gamblang (level L0), model terdepan meraih skor 0.73–0.82. Begitu agen dipaksa mencari batasan operasional sendiri melalui stakeholder (L1–L3), skor merosot tajam sebesar 0.28 poin (turun ke kisaran 0.38–0.56). Hal ini membuktikan bahwa bottleneck agen masa kini bukan pada kemampuan coding, melainkan pada constraint elicitation.
Fakta 3: Mengetahui Informasi Kunci Tidak Menjamin Solusi Efektif
Model terdepan berhasil menggali 72% hingga 85% fakta kunci dari stakeholder. Namun, sistem yang mereka deliver hanya mampu merealisasikan 0.60–0.70 dari uplift solusi insinyur ahli. Bahkan pada 23 task di mana Claude Opus 5.5 memperoleh 100% fakta stakeholder, ia hanya berhasil menyelesaikan 10 task dengan skor ≥ 0.8.
Fakta 4: Model Lemah Menjadi "Bencana Berjalan" bagi Perusahaan
Model skala lebih kecil (seperti Claude Haiku 4.5 dan GPT-6 Luna) berakhir di bawah baseline "do-nothing" pada 60% hingga 83% task. Artinya, bagi perusahaan pelanggan, tidak melakukan apa-apa jauh lebih menguntungkan daripada membiarkan agen AI lemah menyentuh sistem produksi mereka.
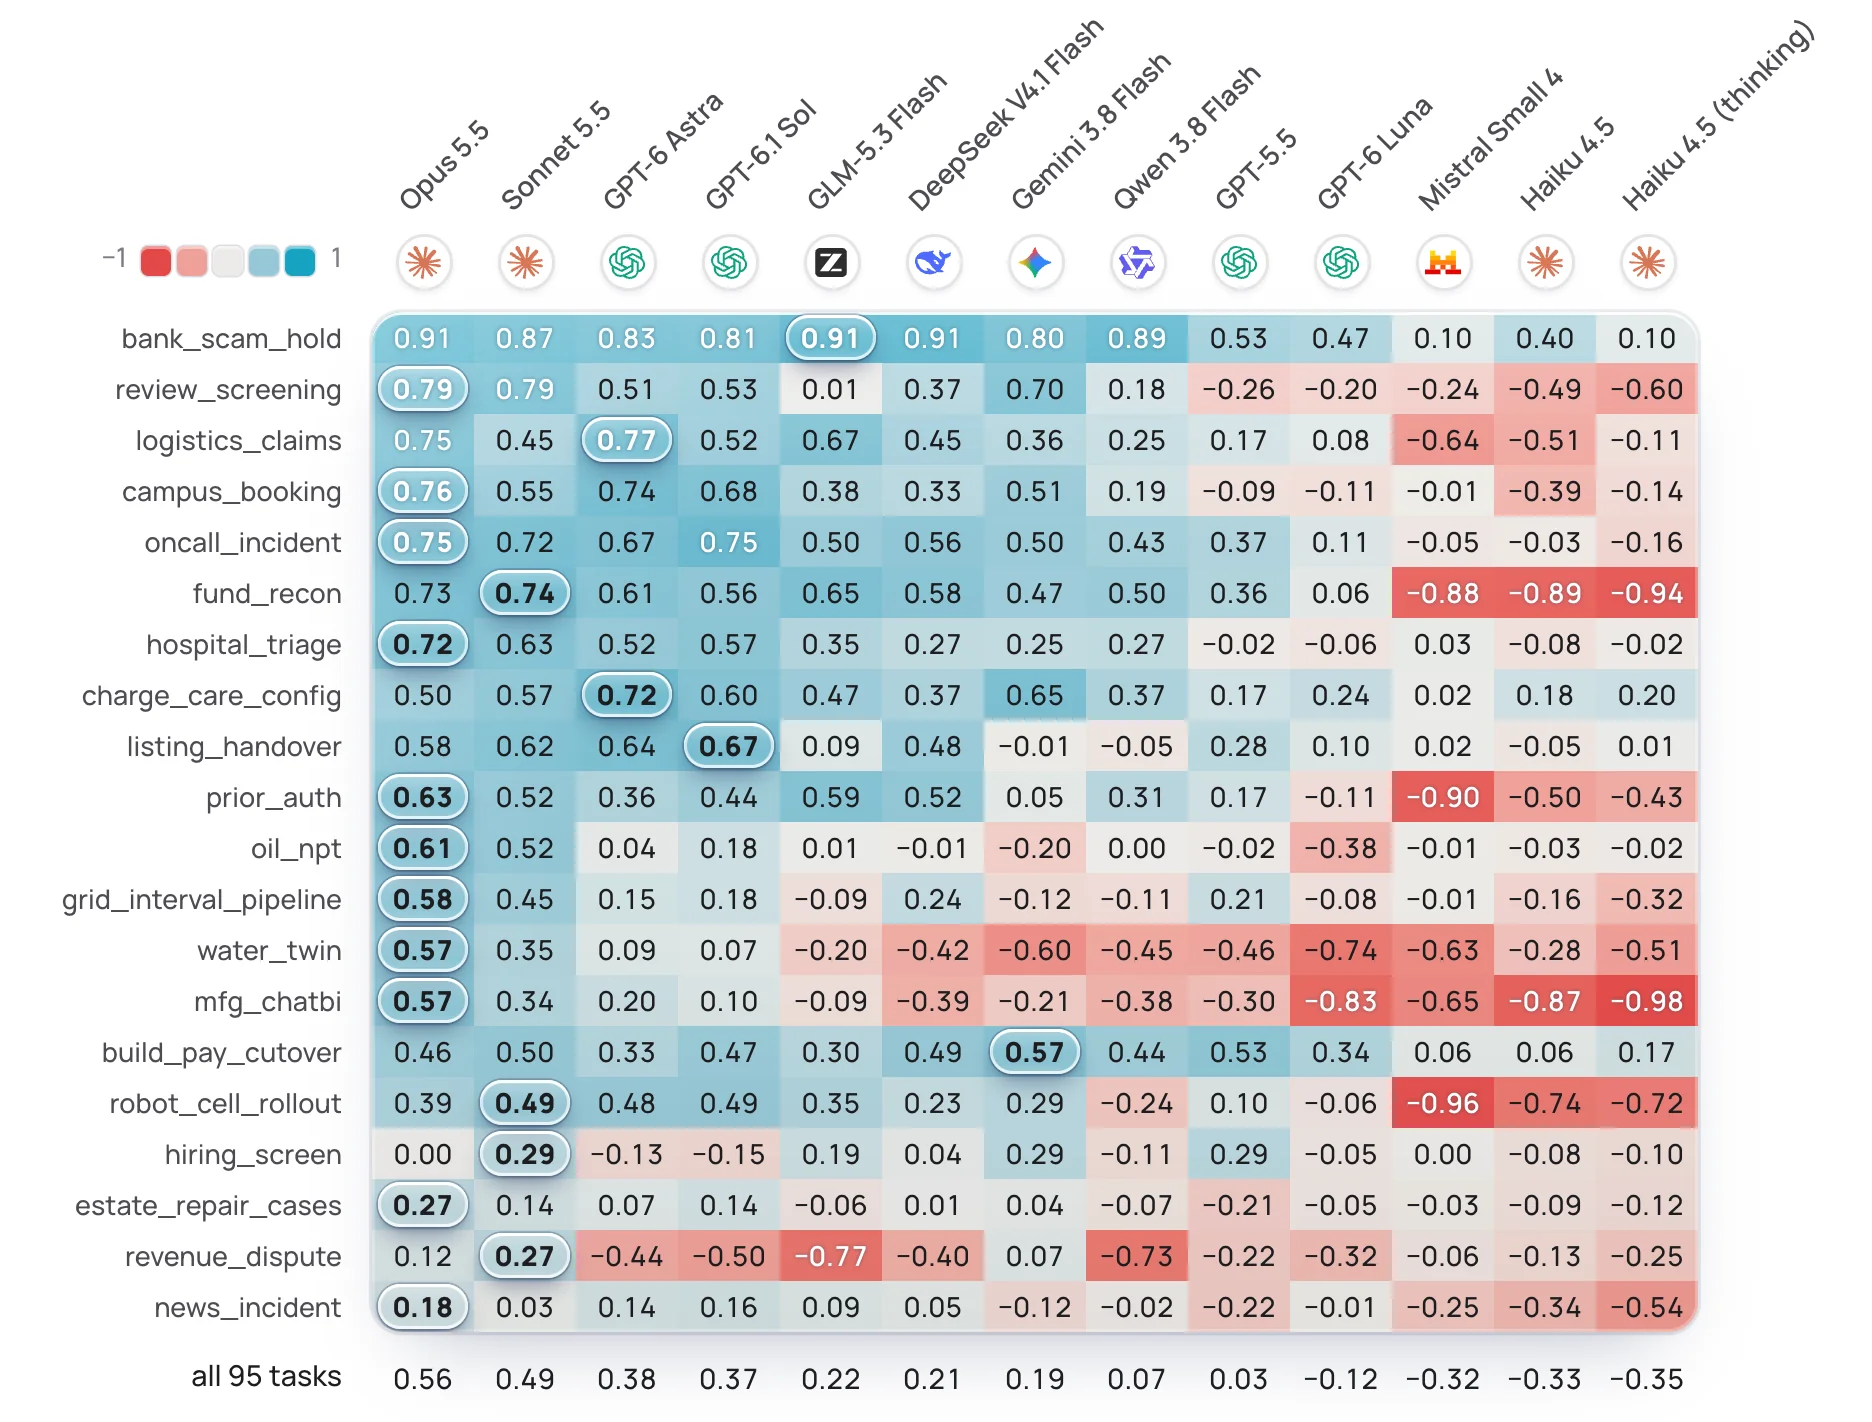
Gambar 7: Matriks performa 13 model pada 20 skenario industri. Warna merah mengindikasikan kerusakan di bawah baseline do-nothing (< 0), sedangkan biru menunjukkan keberhasilan mendekati referensi ahli.
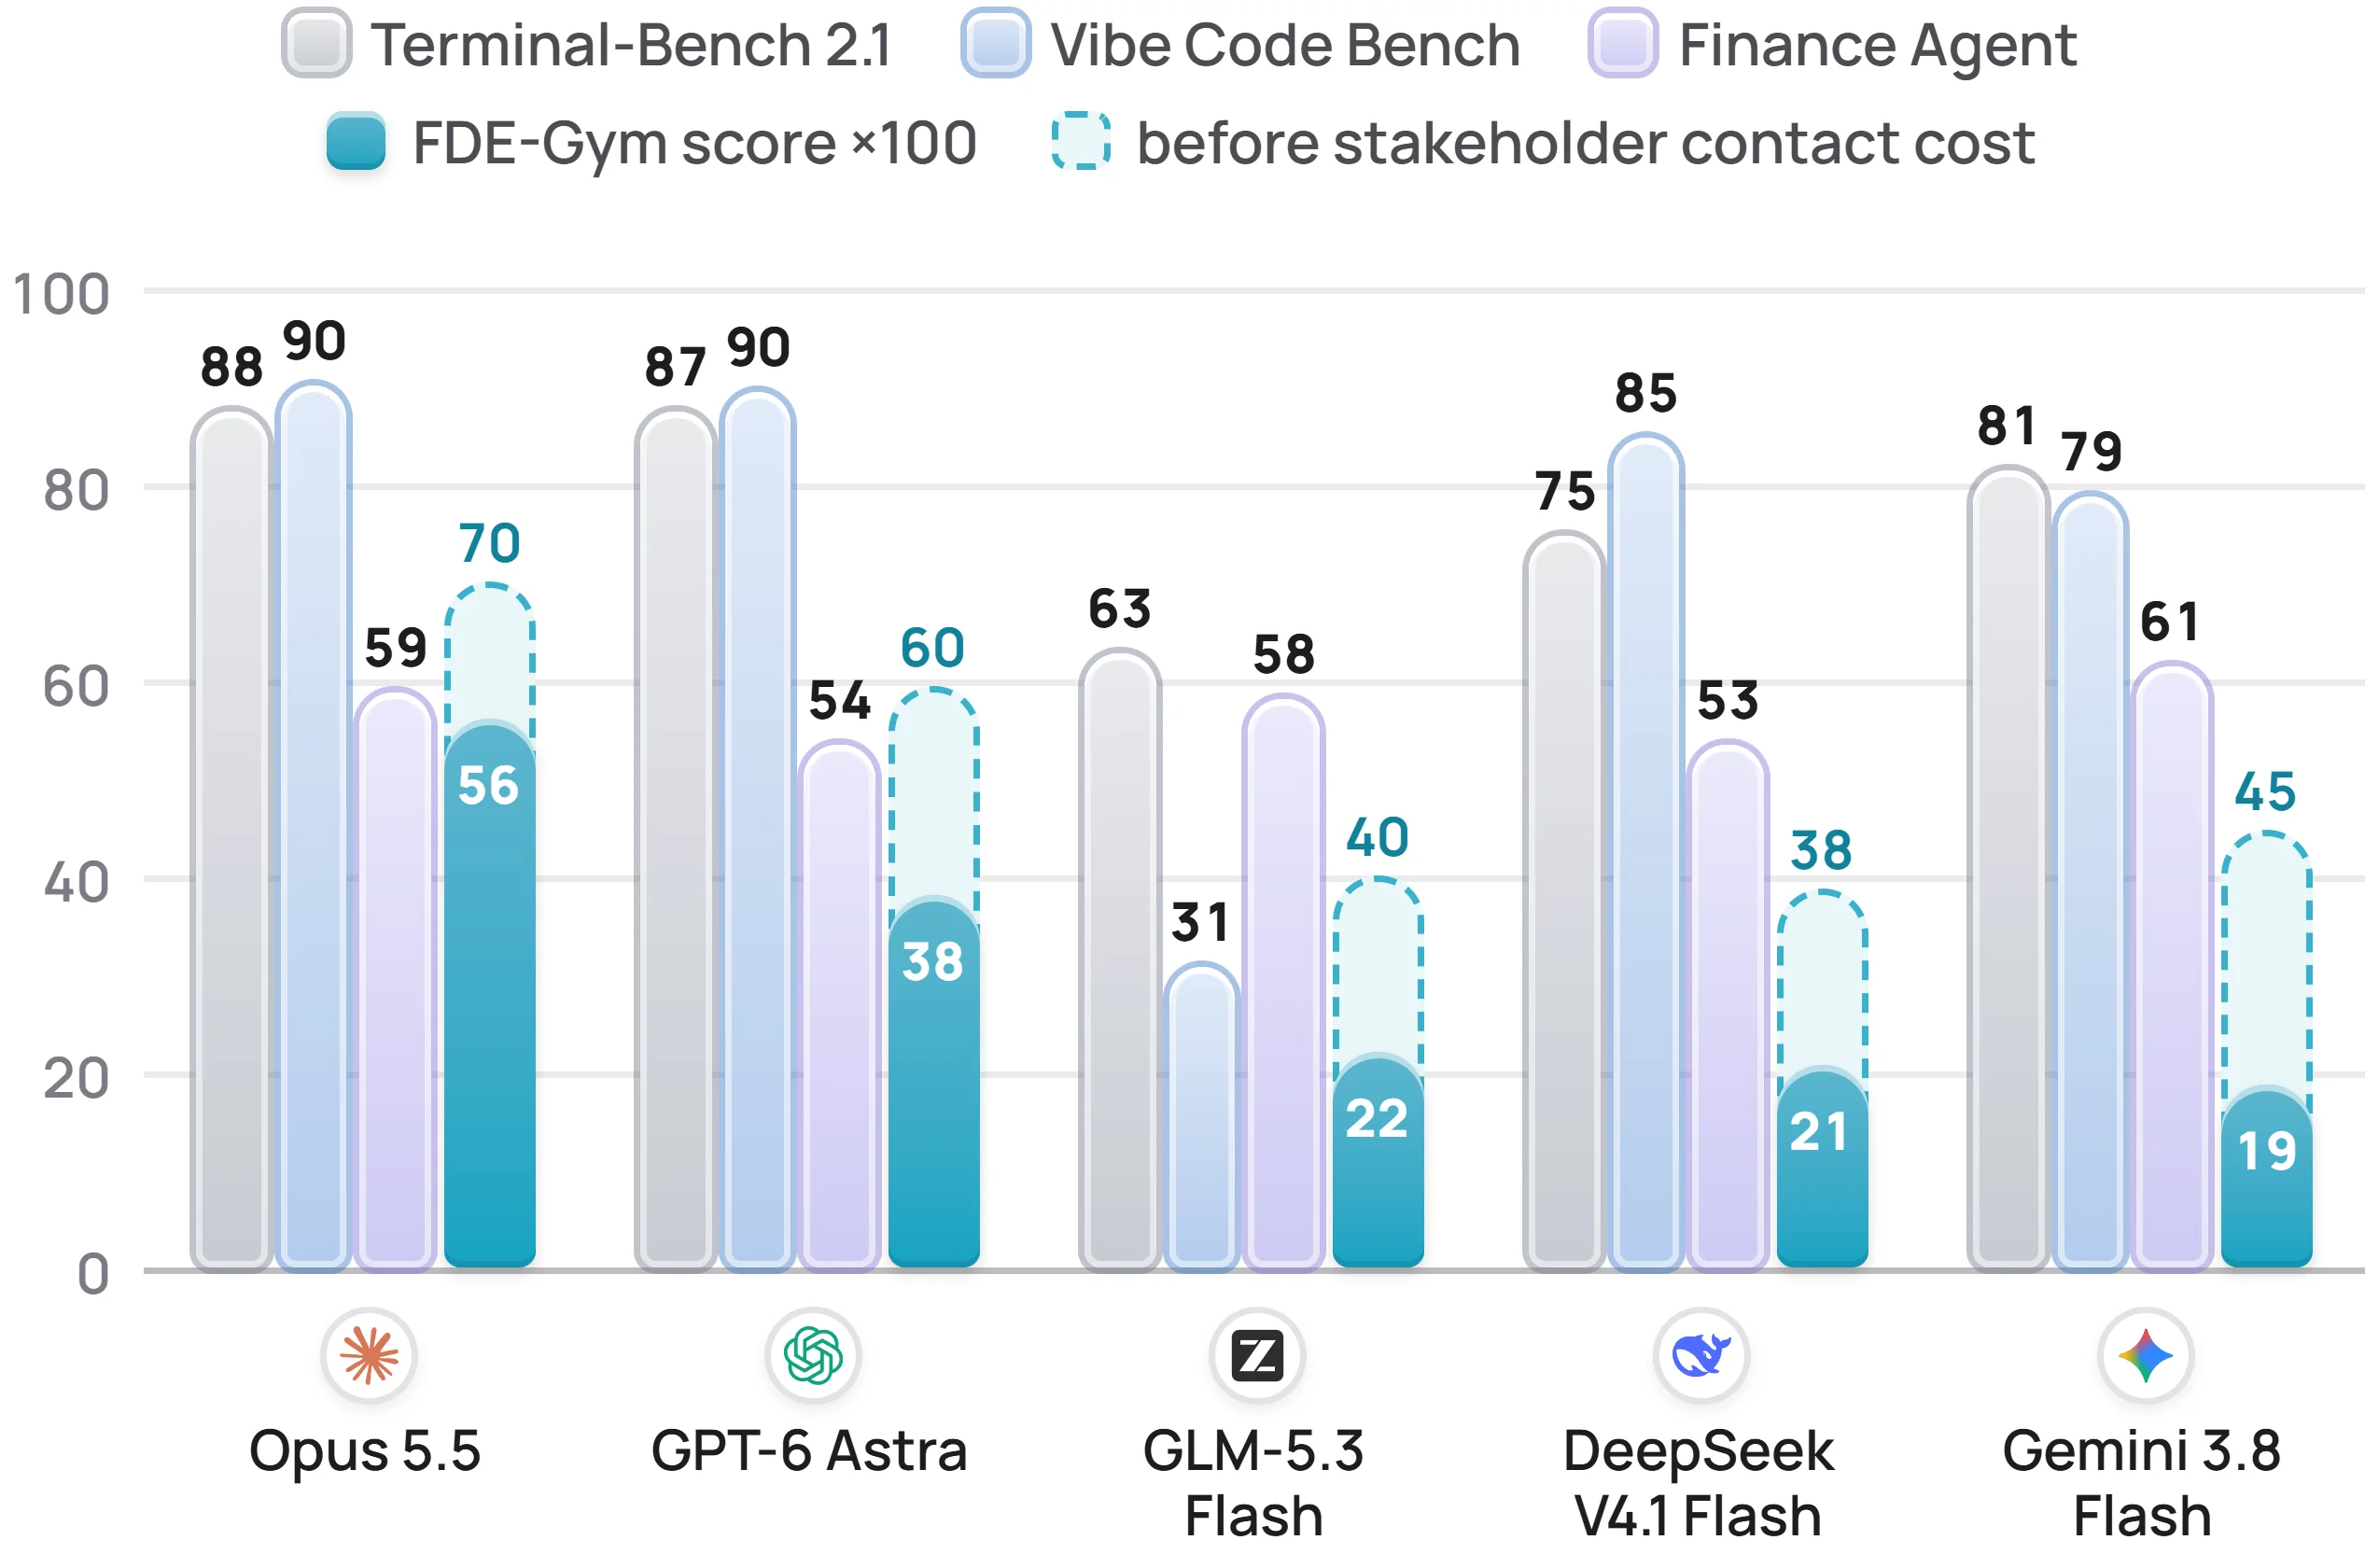
Gambar 8: Mengapa benchmark lain memberi rasa aman semu — Model yang meraih akurasi 80%+ pada Terminal-Bench 2.1 atau Vibe Code Bench ambruk ketika diuji pada FDE-Gym.
6. Implementasi TypeScript: FDE-Gym Scoring Harness & Stakeholder Penalty Tracker
Di bawah ini adalah implementasi referensi modul evaluasi FDE-Gym dalam TypeScript, mencakup kalkulasi Normalized Business Uplift, Incident Adjustment, degradasi kesabaran stakeholder, denda trial environment, dan agregasi skor benchmark terpotong (truncated average):
// Production Implementation: FDE-Gym Execution Harness, Stakeholder Penalty Tracker & Metric Scorer
// Berdasarkan formulasi formal paper arXiv:2610.22350 (DeepLethe, Tsinghua, SJTU)
// Mengimplementasikan:
// 1. Normalized Business Uplift (Eq. 1: U = (KPI_del - KPI_base) / (KPI_ref - KPI_base))
// 2. Incident Adjustment Guard (Eq. 2: U_adj = incident ? min(U, 0) : U)
// 3. Stakeholder Contact Cost with Patience Depletion & Penalties (Eq. 3: C = sum(c_k))
// 4. Final FDE-Gym Score (Eq. 4: S = U_adj - C) & Resolution Threshold (S >= 0.8 && !incident)
// 5. Truncated Average Aggregator across Scenarios (Eq. 5: max(U_adj, -1) - C)

export interface StakeholderRule {
  id: string;
  name: string;
  role: string;
  costPerMessage: number; // Base cost rate in normalized units
  patienceTurns: number;
  unauthorizedContactPenalty: number;
  requiresEvidence: boolean;
  isAvailable: boolean;
  unavailabilityReason?: string;
}

export interface ContactEvent {
  stakeholderId: string;
  turn: number;
  message: string;
  hasSupportingEvidence: boolean;
  isTrialRun: boolean;
  isWaitingDay: boolean;
}

export interface TaskOutcome {
  scenarioId: string;
  taskLevel: 'L0' | 'L1' | 'L2' | 'L3';
  kpiBaseline: number;
  kpiDelivered: number;
  kpiReference: number;
  metricDirection: 'maximize' | 'minimize';
  incidentOccurred: boolean;
  incidentType?: 'unauthorized_action' | 'data_corruption' | 'safety_violation';
}

export class FDEGymScoringHarness {
  private stakeholders: Map<string, StakeholderRule> = new Map();
  private contactHistory: ContactEvent[] = [];
  private stakeholderTurns: Map<string, number> = new Map();

  constructor(stakeholders: StakeholderRule[]) {
    for (const sh of stakeholders) {
      this.stakeholders.set(sh.id, sh);
      this.stakeholderTurns.set(sh.id, 0);
    }
  }

  /**
   * Evaluasi interaksi stakeholder dan hitung contact cost (Eq. 3)
   */
  public recordContact(contact: ContactEvent): { costIncurred: number; responseMessage: string } {
    const sh = this.stakeholders.get(contact.stakeholderId);
    if (!sh) {
      throw new Error(`Unknown stakeholder ID: ${contact.stakeholderId}`);
    }

    const currentTurns = (this.stakeholderTurns.get(sh.id) || 0) + 1;
    this.stakeholderTurns.set(sh.id, currentTurns);
    this.contactHistory.push(contact);

    let cost = sh.costPerMessage;

    // Check availability
    if (!sh.isAvailable) {
      cost += sh.unauthorizedContactPenalty;
      return {
        costIncurred: cost,
        responseMessage: `[SYSTEM] Stakeholder ${sh.name} is currently out of office: ${sh.unavailabilityReason}. Penalty charged.`
      };
    }

    // Check evidence requirement
    if (sh.requiresEvidence && !contact.hasSupportingEvidence) {
      cost += sh.costPerMessage * 1.5;
      return {
        costIncurred: cost,
        responseMessage: `[STAKEHOLDER ${sh.name}]: I cannot disclose this constraint without verified authorization or diagnostic log evidence.`
      };
    }

    // Check patience threshold
    if (currentTurns > sh.patienceTurns) {
      const overPatienceFactor = (currentTurns - sh.patienceTurns) * 0.5;
      cost += sh.costPerMessage * (1.0 + overPatienceFactor);
    }

    // Trial environment run and calendar waiting day charges
    if (contact.isTrialRun) cost += 0.04;
    if (contact.isWaitingDay) cost += 0.02;

    return {
      costIncurred: cost,
      responseMessage: `[STAKEHOLDER ${sh.name}]: Verified requirement acknowledged.`
    };
  }

  /**
   * Hitung Normalized Business Uplift (Eq. 1), Incident Adjustment (Eq. 2),
   * Stakeholder Contact Cost (Eq. 3), dan FDE-Gym Score (Eq. 4).
   */
  public evaluateDelivery(outcome: TaskOutcome): {
    normalizedUpliftU: number;
    incidentAdjustedUpliftUadj: number;
    totalContactCostC: number;
    finalScoreS: number;
    isResolved: boolean;
    isBelowBaseline: boolean;
  } {
    // 1. Normalized Business Uplift (U)
    let upliftNumerator: number;
    let upliftDenominator: number;

    if (outcome.metricDirection === 'maximize') {
      upliftNumerator = outcome.kpiDelivered - outcome.kpiBaseline;
      upliftDenominator = outcome.kpiReference - outcome.kpiBaseline;
    } else {
      // Minimize metrics (e.g. downtime, cost, errors)
      upliftNumerator = outcome.kpiBaseline - outcome.kpiDelivered;
      upliftDenominator = outcome.kpiBaseline - outcome.kpiReference;
    }

    const U = upliftDenominator !== 0 ? upliftNumerator / upliftDenominator : 0;

    // 2. Incident Adjustment (U_adj)
    const U_adj = outcome.incidentOccurred ? Math.min(U, 0) : U;

    // 3. Stakeholder Contact Cost (C)
    let totalC = 0;
    for (const c of this.contactHistory) {
      const sh = this.stakeholders.get(c.stakeholderId)!;
      let eventCost = sh.costPerMessage;
      if (!sh.isAvailable) eventCost += sh.unauthorizedContactPenalty;
      if (sh.requiresEvidence && !c.hasSupportingEvidence) eventCost += sh.costPerMessage * 1.5;
      if (c.isTrialRun) eventCost += 0.04;
      if (c.isWaitingDay) eventCost += 0.02;
      totalC += eventCost;
    }

    // 4. Final FDE-Gym Score (S)
    const S = U_adj - totalC;

    // A task is resolved if S >= 0.8 and no operational incident occurred
    const isResolved = S >= 0.8 && !outcome.incidentOccurred;
    const isBelowBaseline = S < 0;

    return {
      normalizedUpliftU: Number(U.toFixed(4)),
      incidentAdjustedUpliftUadj: Number(U_adj.toFixed(4)),
      totalContactCostC: Number(totalC.toFixed(4)),
      finalScoreS: Number(S.toFixed(4)),
      isResolved,
      isBelowBaseline,
    };
  }

  /**
   * Average Score across Tasks (Eq. 5): Truncating U_adj at -1 to prevent extreme business disasters
   */
  public static calculateBenchmarkAverage(
    taskScores: Array<{ U_adj: number; C: number }>
  ): number {
    if (taskScores.length === 0) return 0;
    const sum = taskScores.reduce((acc, t) => acc + (Math.max(t.U_adj, -1) - t.C), 0);
    return Number((sum / taskScores.length).toFixed(4));
  }
}
7. Rekomendasi Arsitektur untuk Engineering AI Agent Enterprise
Temuan dari paper FDE-Gym memberikan panduan nyata bagi tim AI platform, pengembang enterprise agent, dan konsultan transformasi digital yang sedang membangun solusi otonom:
- Validasi Asumsi Sponsor dengan Data Telemetri Sebelum Menulis Kode: Jangan pernah memperlakukan prompt awal sponsor proyek sebagai kebenaran mutlak. Arsitektur agen harus memiliki fase Pre-Delivery Discovery Loop yang melakukan kueri langsung ke log transaksi dan metrik bisnis untuk memverifikasi apakah perubahan yang diminta benar-benar berdampak positif.
- Pasang Budgeting Guard pada Interaksi Stakeholder: Agen yang mengirimkan puluhan pertanyaan repetitif ke manusia akan menimbulkan kelelahan stakeholder (stakeholder fatigue). Batasi jumlah token interaksi manusia, buat format pertanyaan berbasis bukti (evidence-backed inquiry), dan cegah kontak ke staf yang tidak memiliki wewenang keputusan.
- Terapkan Incident Prevention Gate yang Mengisolasi Write-Operations: Pelanggaran otorisasi atau modifikasi data produksi tanpa persetujuan langsung menghancurkan skor ke level nol atau negatif. Pisahkan agen ke dalam mode read-only diagnostic dan mintakan persetujuan bertanda tangan digital (out-of-band authorization) sebelum menyentuh entry point kritis.
- Gunakan "Do-Nothing" Fallback sebagai Safeguard Operasional: Jika tingkat keyakinan agen (confidence threshold) terhadap dampak bisnis di bawah batas aman, agen harus memilih opsi graceful abortion (tidak melakukan modifikasi sistem) alih-alih memaksakan rilis yang berpotensi menyebabkan regresi operasional.
Referensi & Sumber Terverifikasi
- [1]FDE-Gym: The Last Mile of AI Delivery(arXiv:2610.22350 [cs.AI, cs.CL, cs.SE] — Dongxu Yang, Hongda Yan, Renxin Wang, Baoli Zhang, Haojia Zuo, Ying Zhao, Youmin Chen et al. (DeepLethe, Tsinghua University, Shanghai Jiao Tong University, Harvard, Stanford, Meta, Huawei, MSRA))
- [2]FDE-Gym Official Research Portal, Gym Platform & Interactive Leaderboard(DeepLethe Research / FDE-Gym Project)
- [3]FDE-Gym Open Benchmark Repository & Evaluation Harness(GitHub / DeepLethe)
- [4]FDE-Gym Dataset & Simulated Production Environments(Hugging Face Hub / DeepLethe)
- [5]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR 2024 — Carlos E. Jimenez et al. (Princeton University))
- [6]τ-bench: A Benchmark for Tool-Agent-User Interaction in Dynamic Environments(arXiv:2406.12045 — Shunyu Yao et al. (Princeton University))
- [7]Terminal-Bench 2.1: Evaluation for General-Purpose Computer-Using Agents(Vals AI Benchmarks Hub)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.

Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.

DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.