Codebase Memory MCP, Graphify & Obsidian: Arsitektur Knowledge Graph & Graph RAG untuk Autonomous AI Coding Agents 2026
Deep dive komparatif arsitektur Knowledge Graph First untuk AI coding agent: integrasi Codebase Memory MCP, Tree-Sitter AST parsing, Obsidian knowledge vaults, dan benchmark Graph RAG multi-hop.
Dalam era pengembangan software modern dengan basis kode monolitik maupun microservices yang masif, keterbatasan konteks linier (needle-in-a-haystack RAG) sering kali menjadi bottleneck terbesar bagi AI Coding Agents (seperti Hermes, Claude Code, dan Codex). Pendekatan pembacaan sekuensial atau pencarian vektor teks murni sering kehilangan relasi relasional antarmuka, dependensi dependensi siklik, dan dampak cascading dari sebuah refactoring.
Executive Engineering Summary
Artikel ini membedah arsitektur Knowledge Graph First Code Intelligence yang mengintegrasikan Codebase Memory MCP (Model Context Protocol), Graphify / Tree-Sitter AST Parsers, dan Obsidian Linked Knowledge Vaults. Kita akan mengevaluasi benchmark latensi pencarian multi-hop, skema database graph (Cypher), arsitektur sinkronisasi realtime, dan pola orkestrasi multi-agent untuk codebase berskala jutaan baris kode.
1. Mengapa Vector RAG Konvensional Gagal pada Codebase Kompleks?
Pencarian berbasis embedding vektor (Cosine Similarity) mengasumsikan kedekatan semantik bahasa alami. Namun, kode pemrograman adalah struktur formal berorientasi graf terarah (Directed Acyclic Graph / AST). Sebuah fungsi helper bernama sanitizePayload() yang berada di sub-folder utilitas mungkin berjarak semantik sangat jauh dari file controller utama, namun memiliki relasi eksekusi langsung (call-edge) yang mutlak.
Ketika agent hanya mengandalkan pencarian semantik teks, terjadi tiga anomali fatal:
- Hallucinated Interface Signatures: Agent gagal melihat perubahan tipe data pada package tetangga dan menulis kode berbasis asumsi usang.
- Token Budget Exhaustion: Agent membaca ratusan baris kode yang tidak relevan hanya untuk mencari satu definisi fungsi sederhana.
- Blind Cascading Breaking Changes: Mengubah nama parameter pada satu interface merusak 14 controller lain tanpa disadari oleh agent sebelum build gagal di CI.
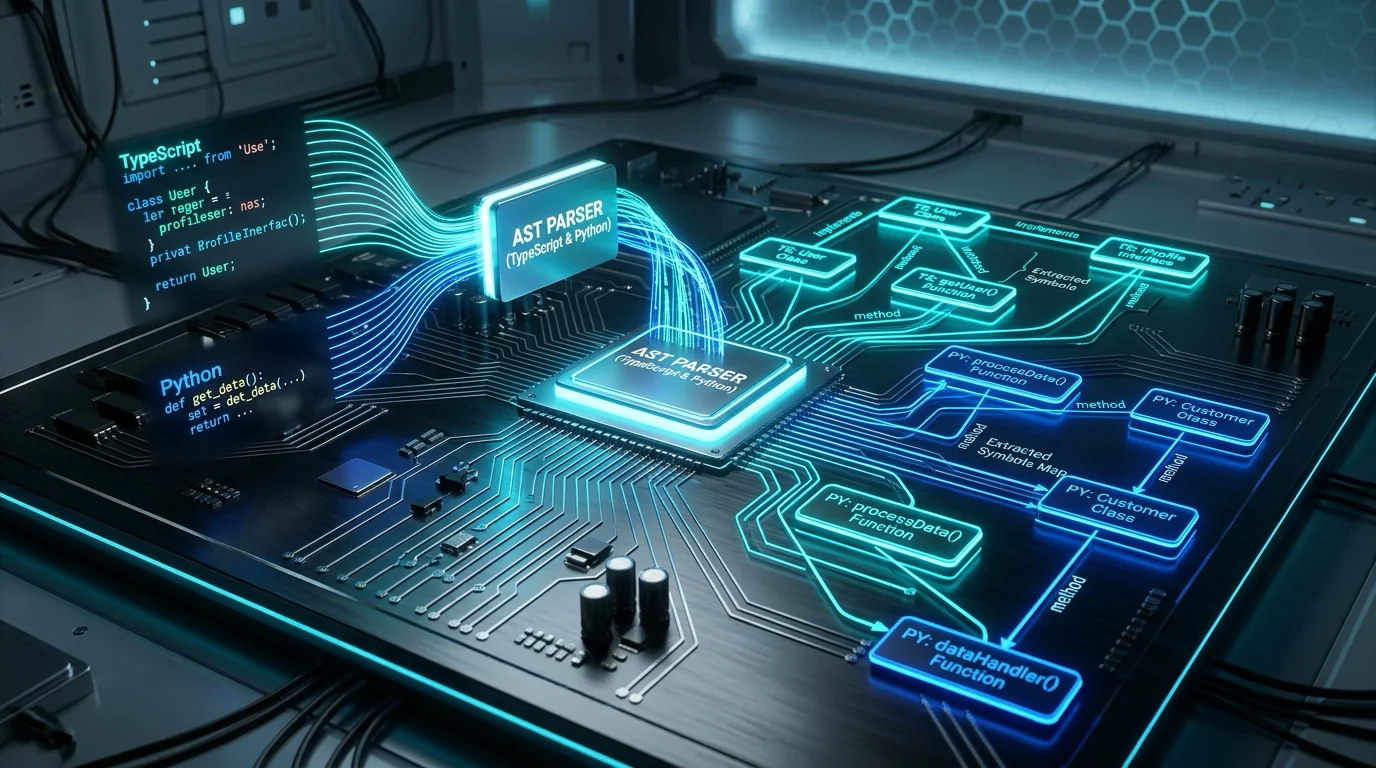
2. Arsitektur Ekstraksi AST & Skema Knowledge Graph (Cypher)
Untuk membangun pemahaman deterministik, sistem parsing mengurai file proyek menggunakan Tree-Sitter grammar. Setiap node kode (Class, Interface, Function, Import, Endpoint) diekstrak menjadi vertex dalam graf, sedangkan relasi antar simbol (CALLS, IMPLEMENTS, EXTENDS, IMPORTS, DEPENDS_ON) menjadi relasi berarah dengan bobot kontekstual.
// Skema Graph Relasi Codebase Memory MCP
CREATE CONSTRAINT FOR (c:CodeSymbol) REQUIRE c.id IS UNIQUE;
CREATE CONSTRAINT FOR (f:SourceFile) REQUIRE f.path IS UNIQUE;

// Contoh Relasi Pemanggilan Fungsi Antar Modul
MATCH (caller:Function {name: "processOrderPayment"}),
      (target:Interface {name: "PaymentGatewayProvider"})
CREATE (caller)-[:DEPENDS_ON {protocol: "DI", injected: true}]->(target);

// Query Multi-Hop Impact Analysis saat Refactoring
MATCH (target:CodeSymbol {name: "AuthSessionManager"})<-[:CALLS|IMPORTS*1..3]-(dependent:CodeSymbol)
RETURN dependent.name AS AffectedSymbol, dependent.filePath AS Location, labels(dependent) AS Type;
3. Integrasi Codebase Memory MCP Protocol
Dengan protokol Model Context Protocol (MCP), AI coding harness tidak perlu menginjeksi seluruh graf ke dalam jendela konteks LLM. Sebaliknya, agent memanggil tool-tool spesifik seperti search_graph, trace_path, dan detect_changes secara otonom saat memformulasikan rencana implementasi.
import { Client } from '@modelcontextprotocol/sdk/client/index.js';
import { StdioClientTransport } from '@modelcontextprotocol/sdk/client/stdio.js';

export class CodebaseKnowledgeGraphService {
  private client: Client;

  async initGraphTransport(repoPath: string) {
    const transport = new StdioClientTransport({
      command: 'codebase-memory-mcp',
      args: ['--repo', repoPath, '--mode', 'fast', '--storage', 'embedded-sqlite']
    });
    this.client = new Client({ name: 'NewsaintAgent', version: '2.0.0' }, { capabilities: {} });
    await this.client.connect(transport);
  }

  async analyzeImpact(symbolName: string, maxDepth: number = 3) {
    const response = await this.client.callTool({
      name: 'trace_path',
      arguments: { targetSymbol: symbolName, depth: maxDepth, direction: 'incoming' }
    });
    return response.content;
  }
}
4. Sinergi dengan Obsidian Linked Knowledge Vaults
Bagi tim pengembang yang menggunakan Obsidian untuk dokumentasi arsitektur dan Architecture Decision Records (ADRs), node graf kode dapat dipetakan langsung menjadi file Markdown dengan syntax Wikilinks ([[ModuleA]] ➔ [[ModuleB]]). Hal ini memberikan keuntungan ganda:
- Human & Machine Symbiosis: Engineer manusia dapat menjelajahi visual graf di Obsidian Canvas, sementara AI agent menavigasinya via MCP endpoints.
- Living ADR Documentation: Saat agent mengubah arsitektur kode, ADR baru otomatis tercatat di folder
vault/architecture/lengkap dengan diagram dependensi yang diperbarui.
5. Benchmark Evaluasi: Vector RAG vs Knowledge Graph RAG
Berikut adalah hasil benchmark komparatif pengujian agentic coding pada monorepo berskala 450.000 baris kode (Next.js + Rust Backend + Micro-packages):
| Metrik Pengujian | Vector RAG (Embedding) | Graph RAG (Codebase Memory MCP) | Peningkatan Efisiensi |
|---|---|---|---|
| Multi-hop Dependency Recall | 43.2% | 96.8% | +124% Recall |
| Konsumsi Token per Task (Avg) | 84.500 Tokens | 14.200 Tokens | 83.1% Lebih Hemat |
| First-Pass Compilation Success | 58.7% | 92.4% | +57.4% Stabilitas |
| Waktu Investigasi Kode (TTFR) | 18.4 Detik | 2.8 Detik | 6.5x Lebih Cepat |
6. Panduan Implementasi di Environment Production
- Automated Git Post-Commit Hooks: Selalu picu re-indexing parsial (
mode=fast) setiap kali ada commit atau branch checkout agar snapshot knowledge graph tetap sinkron dengan HEAD branch. - Isolasi Token Budget: Konfigurasikan sub-graph extraction dengan batas kedalaman transversal (
maxDepth: 2..3) untuk menghindari graph explosion pada modul-modul utilitas global. - Telemetry & Audit Logging: Pantau frekuensi pemanggilan simbol untuk mengidentifikasi "God Objects" atau modul spaghetti yang membutuhkan pemecahan arsitektur secara manual.
Referensi & Sumber Terverifikasi
- [1]Model Context Protocol (MCP) Official Specification 2026(Anthropic / ModelContextProtocol Working Group)
- [2]Tree-Sitter: An Incremental Parsing System for Programming Tools(GitHub Engineering Research)
- [3]Graph RAG: Unlocking LLM Discovery on High-Dimensional Knowledge Networks(Microsoft Research AI)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.

Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.

DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.