AgentKV 2026: Arsitektur Phase-Aware KV Eviction, Principal-Angle Subspace Discrepancy, dan Online Page Compaction pada High-Throughput Agentic LLM Serving
Analisis arsitektur mendalam atas riset frontier arXiv:2609.14872 (September 2026, Taowen Liu et al.): Mengapa metode kompresi KV cache konvensional (R-KV, SnapKV, H2O) runtuh pada autonomous LLM agents akibat asumsi keseragaman temporal. Eksplorasi Principal-Angle Subspace Analysis membuktikan bahwa query space antar fase (think, act, tool, others) menempati dimensi geometris ortogonal yang berbeda. AgentKV memperkenalkan token-level streaming phase parser, union representative query scoring, serta online physical page compaction pada SGLang 0.5.12 + FlashInfer yang melipatgandakan throughput inferensi hingga 1.80x dan mengungguli baseline sebesar +5.5 poin pada BFCL dan Tau-bench.
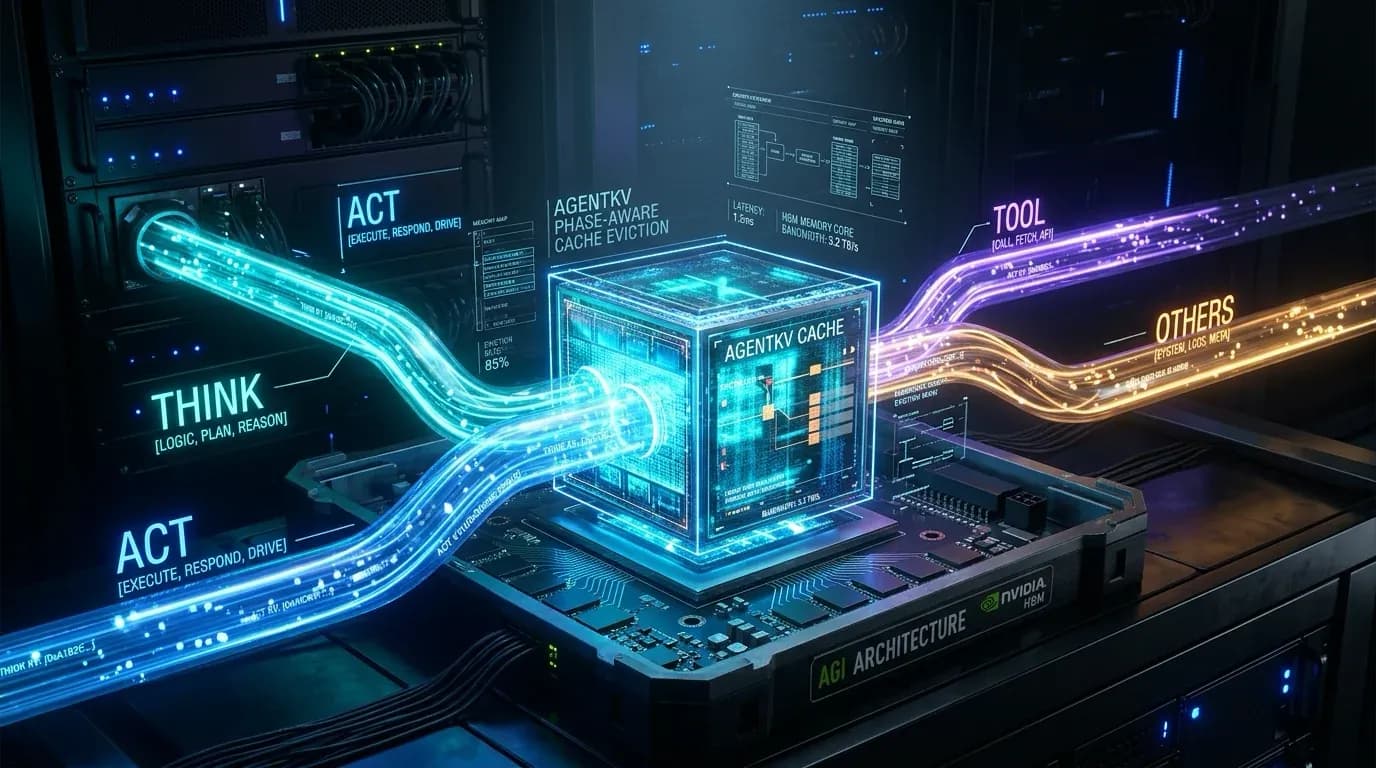
Dalam lanskap infrastruktur kecerdasan buatan terdistribusi tahun 2026, pergeseran beban kerja dari single-turn chat menuju Autonomous Multi-Turn AI Agents (seperti sistem coding mandiri, browser automation, dan enterprise workflow runners) telah menciptakan krisis komputasi baru. Agen otonom mengonsumsi token beberapa orde magnitudo lebih masif dibandingkan chatbot konvensional. Setiap siklus observasi lingkungan, pemanggilan tool MCP, dan sintesis langkah penalaran (Chain-of-Thought) mengakibatkan akumulasi Key-Value (KV) cache yang mencekik kapasitas High-Bandwidth Memory (HBM) GPU serta mendegradasi decoding memory bandwidth.
Ringkasan Arsitektur Eksekutif
Riset frontier terbaru dari Taowen Liu et al. (arXiv:2609.14872, September 2026) memperkenalkan AgentKV: Kerangka kerja kompresi KV cache pertama yang dirancang khusus untuk pola lintasan agen otonom. Melalui analisis Principal Angles, riset ini membuktikan secara matematis bahwa vektor query dari empat fase eksekusi agen (think, act, tool, dan others) menempati subruang geometri yang ortogonal dan berbeda. Algoritma eviksi berbasis kebaruan (recency-based) konvensional menderita bias estimasi parah yang membuang informasi lingkungan krusial. AgentKV memadukan Token-Level Streaming Phase Parser, Union Representative Scoring, dan Online Physical Page Compaction pada serving engine SGLang 0.5.12, menghasilkan lonjakan throughput decoding hingga 1.80x serta peningkatan akurasi rata-rata +5.5 poin pada benchmark BFCL dan Tau-bench.
1. Keruntuhan Asumsi Keseragaman Temporal pada Lintasan Agen Otonom
Metode kompresi KV cache terdahulu—termasuk algoritma terkemuka seperti StreamingLLM, H2O (Heavy Hitter Oracle), SnapKV, dan R-KV—dibangun di atas premis bahwa atensi masa depan dapat diproyeksikan secara akurat oleh pola atensi dari jendela token terbaru (recency window). Pada percakapan teks biasa, hipotesis ini bekerja cukup memadai karena distribusi semantik bergeser secara halus dan bertahap.
Namun, pada agen otonom, asumsi ini runtuh secara mendasar. Trajektori agen tidak bergerak secara linier seragam, melainkan berosilasi di antara empat fase diskrit yang berulang:
1. Fase Think (Penalaran Internal)
Blok penalaran Chain-of-Thought (CoT) di dalam tag <think>...</think> tempat model membedah masalah, merumuskan hipotesis, dan memvalidasi batasan sebelum mengambil tindakan fisik.
2. Fase Act (Pemanggilan Alat)
Emisi sintaksis aksi dalam tag <tool_call>...</tool_call> yang menyusun parameter fungsi, payload JSON, nama API endpoint, dan format argumen target.
3. Fase Tool (Observasi Lingkungan)
Respons mentah yang dikembalikan oleh lingkungan eksternal dalam tag <tool_response>...</tool_response>, mencakup stack trace terminal, hasil query SQL, atau DOM scraping.
4. Fase Others (Instruksi & Dialog)
Definisi skema tool sistem, batasan etika pada system prompt, dan pertanyaan atau koreksi interaktif yang dimasukkan oleh pengguna di awal maupun tengah giliran.
Ketika sistem kompresi KV konvensional melakukan eviksi saat model sedang berada di akhir fase think atau act, query representatif yang digunakan untuk menilai kepentingan seluruh memori masa lalu hanya berasal dari jendela token think/act tersebut. Akibatnya timbul recency estimator bias: model menilai token observasi dari tool sebelumnya serta parameter skema pada others memiliki skor atensi rendah, lalu menghapusnya dari HBM. Ketika langkah berikutnya tiba dan agen perlu merujuk kembali hasil eksekusi tool untuk memformulasikan jawaban akhir, token esensial tersebut telah hilang, memicu halusinasi fatal dan kegagalan eksekusi skrip.
2. Pembuktian Matematis: Analisis Principal Angles pada Subruang Query
Untuk membuktikan bahwa query dari setiap fase memang memiliki karakteristik representasi yang tidak kompatibel, para peneliti AgentKV menerapkan teknik Principal Angles Subspace Analysis.
Setiap trajektori dibagi menjadi rentang fase kontigu $s$. Untuk rentang $s$ yang memiliki $n_s$ token, vektor-vektor query $d$-dimensinya disusun ke dalam matriks $X_s in mathbb{R}^{n_s imes d}$. Kemudian dilakukan dekomposisi nilai singular tipis (thin SVD):
Di mana $k$ vektor singular kanan pertama, $V_{s,k} in mathbb{R}^{d imes k}$, membentuk basis ortonormal yang merangkum arah dominan dari subruang query pada rentang fase tersebut. Untuk membandingkan dua rentang fase $s_1$ dan $s_2$, sudut-sudut prinsipal $ heta_1, heta_2, dots, heta_k$ dihitung melalui SVD dari perkalian silang basis ortonormalnya:
Temuan Empiris Kunci (Key Empirical Finding)
Hasil komputasi sudut prinsipal pada setiap attention head dan layer model frontier (Qwen3-8B dan Qwen3-32B) menunjukkan bahwa sudut antar-fase ($ heta_{ ext{cross-phase}}$) secara konsisten mendekati $pi/2$ (90 derajat ortogonal), jauh lebih besar daripada sudut intra-fase ($ heta_{ ext{intra-phase}}$). Artinya, ruang query saat berpikir sama sekali tidak selaras dengan ruang query saat mengamati output tool. Menggunakan query fase terbaru untuk memprediksi kebutuhan fase lain adalah kekeliruan matematis fatal.
3. Arsitektur Inti AgentKV: Dari Streaming Parsing ke Union Scoring
Menyadari bahwa bias estimasi kebaruan adalah akar masalah, AgentKV merancang alur kompresi yang menjamin setiap fase representatif memiliki hak suara yang setara dalam menentukan token mana yang harus dipertahankan.
Pipeline Eksekusi Modular AgentKV
3.1 Formulasi Skoring Utilitas Global Tanpa Kuota Buatan
Salah satu keunggulan desain AgentKV adalah ketiadaan kuota buatan per fase. Alih-alih menetapkan aturan kaku seperti "pertahankan 25% token think dan 25% token tool", AgentKV membiarkan seluruh key berkompetisi secara bebas terhadap himpunan query representatif gabungan $mathcal{Q}^{(e)}$:
Skor $s_j$ merefleksikan utilitas intrinsik sebuah token terhadap seluruh fase operasi agen di masa depan. Token observasi tool yang bernilai tinggi akan tetap bertahan secara alami meskipun sistem baru saja menyelesaikan fase reasoning panjang.
4. Implementasi Serving-Aware: Online Physical Page Compaction pada SGLang
Banyak riset kompresi KV akademis hanya melakukan logical masking pada atensi tanpa pernah membebaskan memori GPU secara fisik. Pada arsitektur serving produksi, jika halaman memori yang dievokasi tidak dikembalikan ke memory allocator, kapasitas batching tidak akan bertambah dan latensi transfer bandwidth tetap tinggi.
AgentKV diintegrasikan langsung ke dalam runtime SGLang 0.5.12 yang didukung oleh kernel FlashInfer:
-
Persistent Trajectory State Preservation: KV cache dipertahankan sebagai state persisten melintasi giliran tool call dan dialog user. Compaction dijalankan secara online tanpa merusak snapshot chunked prefill.
-
Physical Page Compaction: Entri KV yang dipertahankan dikumpulkan (gathered) ke dalam slot fisik baru yang padat. Seluruh blok paged-attention yang kosong segera ditandai bebas dan dikembalikan ke pool alokasi GPU.
-
CUDA Graph Capture Compatibility: Struktur decoding pointer dijaga tetap stabil sehingga eksekusi decoding token berikutnya tetap dapat memanfaatkan akselerasi CUDA Graph tanpa fallback ke runtime kernel lambat.
5. Hasil Evaluasi Benchmark: BFCL, Tau-Bench, dan Throughput 1.80x
Efektivitas AgentKV diuji secara komprehensif menggunakan dua model frontier (Qwen3-8B dan Qwen3-32B) pada enam domain tugas agen otonom: Berkeley Function-Calling Leaderboard (BFCL) pada kategori web_search, multi_turn, memory, serta Tau-Bench ($ au^2$-bench) pada domain airline, retail, dan telecom.
| Model & Metode | Budget (Tokens) | BFCL Web Search | BFCL Multi-Turn | BFCL Memory | Tau Airline | Tau Retail | Tau Telecom |
|---|---|---|---|---|---|---|---|
| Qwen3-32B Full KV (Uncompressed) | Full (~32k) | 28.0% | 52.0% | 24.8% | 44.0% | 53.5% | 25.4% |
| Qwen3-32B AgentKV (Phase-Aware) | 2048 / 4096 | 22.0% | 48.0% | 22.8% | 40.0% | 50.9% | 21.9% |
| Qwen3-32B R-KV (Recency Baseline) | 2048 / 4096 | 13.0% | 37.0% | 23.9% | 26.0% | 44.7% | 7.9% |
| Qwen3-32B Tri-attention | 2048 / 4096 | 21.0% | 44.0% | 24.3% | 40.0% | 39.5% | 10.5% |
| Qwen3-8B AgentKV | 1024 / 2048 | 16.0% | 38.0% | 18.7% | 34.0% | 30.7% | 18.4% |
| Qwen3-8B R-KV | 1024 / 2048 | 6.0% | 20.0% | 15.9% | 32.0% | 28.9% | 18.4% |
Dari data empiris di atas terlihat bahwa pada tugas interaktif multi-turn dan pemanggilan tool yang ketat (seperti BFCL Multi-Turn dan Tau Telecom), baseline R-KV mengalami degradasi performa hingga lebih dari 50% akibat terhapusnya token observasi lingkungan. Sebaliknya, AgentKV mempertahankan hingga 90–95% kemampuan model Full KV asli hanya dengan sebagian kecil alokasi cache.
Throughput Serving Nyata pada NVIDIA H100 NVL & RTX A6000
Pada pengujian throughput token output di kluster komputasi NVIDIA H100 NVL dengan konfigurasi prompt 16k hingga 32k token:
1. Regime Bandwidth-Bound (16k prompt / 1k gen): AgentKV memangkas traffic pembacaan memori KV saat decoding, meningkatkan output throughput sebesar 1.45x.
2. Regime Capacity-Bound (32k prompt / 1k gen): Melalui pengembalian halaman memori ke allocator secara fisik, kapasitas konkuren meningkat drastis, mencapai peningkatan throughput sebesar 1.80x dibandingkan implementasi bawaan SGLang 0.5.12 tanpa kompresi.
6. Panduan Implementasi untuk Arsitektur Produksi 2026
Keberhasilan AgentKV menggarisbawahi prinsip desain fundamental bagi para arsitek sistem AI dan engineer infrastruktur serving:
- Hentikan Penggunaan Algoritma Recency Tunggal pada Agen: Sistem seperti SnapKV atau StreamingLLM hanya cocok untuk chatbot linier. Menggunakannya pada agen autonomous yang berinteraksi dengan API eksternal hanya akan menimbulkan bug silent failure dan loop halusinasi.
-
Manfaatkan Chat-Template Semantic Parsing:
Membedakan fase eksekusi tidak memerlukan model klasifikasi BERT atau neural classifier tambahan. Cukup parsing tag template chat standar (
<think>,<tool_call>,<tool_response>) pada level tokenizer streaming. - Wajibkan Physical Compaction: Kompresi KV tanpa pembebasan halaman memori fisik adalah pemborosan sumber daya. Pastikan serving engine Anda (baik SGLang, vLLM, maupun TensorRT-LLM) mengadopsi mekanisme realokasi blok fisik untuk membuka ruang konkurensi request yang lebih besar.
Referensi & Sumber Terverifikasi
- [1]AgentKV: Phase-Aware KV Eviction for Agentic LLMs(arXiv:2609.14872 [cs.LG, cs.AI, cs.CL] — Taowen Tony Liu, Jeffrey T. H. Wong, Can Xiao, Bowen Yang, Hao Mark Chen, Yiren Zhao)
- [2]Official AgentKV Open-Source Implementation & SGLang Serving Engine Integration(GitHub Repository: LiuTaowen-Tony/agentkv)
- [3]SGLang: Efficient Execution of Structured Language Model Programs with FlashInfer Attention(LMSYS Organization / arXiv:2312.07104)
- [4]Berkeley Function-Calling Leaderboard (BFCL): Comprehensive Benchmark for Tool Calling LLM Agents(Gorilla LLM Project / UC Berkeley)
- [5]Tau-Bench: A Benchmark for Tool-Agent User Interaction in Real-World Dynamic Environments(Sierra Research & Princeton University / arXiv:2406.12045)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.

Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.

DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.